PNGTuberの素材を作るのに最適なAIを考える
約 30 分で読めます
キャラデザから立ち絵、差分画像までを複数の画像生成 AI で用意して、PNGTuber の素材作成に最適な AI を考えます。
Peraravatar+ のサンプル作成のためにいろいろと AI に画像生成をさせてきましたが、結局 PNGTuber にはどれを使うのが最適なのか。自分の中ではある程度答えが出たのですが、確かめたわけではないので、改めて複数の画像生成 AI にアバターの画像を出力させて、PNGTuber の素材作りに最適な AI を検証することにしました。
丁度、知り合いの配信者の誕生日が近いので、その子の REALITY のアバターを参考に、Peraravatar+ で使う PNGTuber アバターの素材を用意しがてら、いろんな生成方法を試してみようと思います。REALITY は、スマホのインカメラに顔を写すとアバターが連動して動く、スマホ向けの配信アプリです。REALITY から YouTube などに配信の場を移すときに、使っていたアバターのデザインを元に新しいアバターを用意する人が多いので、これを例にします。
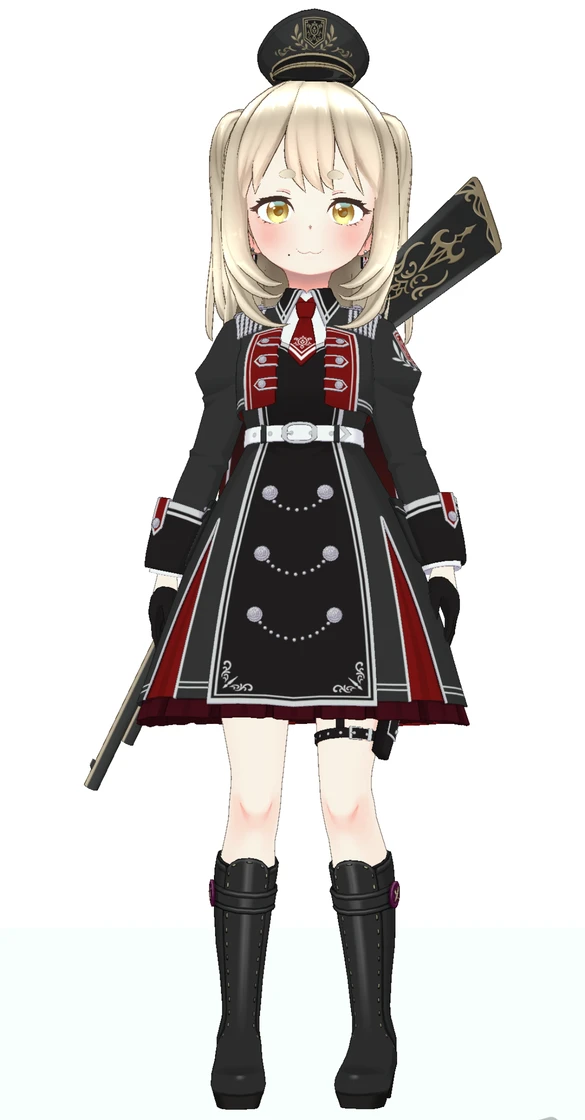
「PNGTuber の記事書くのにぴよの REALITY アバターを参考に使っていい?」って聞いたら、快諾してくれました。その割に「ドメイン取って SEO 対策して検索でぴよの公式ページがヒットするようにしよう!」って提案したら恥ずかしいって拒否されたことがあるので、直接リンクはしないでおきます。Achievements に私が作った公式サイトがあります。
比較内容
ChatGPT・Gemini・Grok・PixAI・ComfyUI に、同じようなプロンプトで画像を出力させて比べます。使用するのはすべて無料のサービスとツールで、有料プランのオプションは使用しません。比べるのは以下。
- キャラデザ: 具体的なイメージが決まっていない状態で、ざっくりしたイメージだけ伝えていい感じのキャラクターを出力してくれるか
- 画像から再生成: 参考画像(ない場合はキャラデザで一番気に入ったもの)を渡して、アバター用の立ち絵を出力してくれるか
- 差分画像: 画像から再生成で出力した中から選んだ1枚を渡して、目だけを閉じた画像を頼んだときに、他の部分を変えずに出力してくれるか
背景を透過した画像の出力は苦手な AI が多いので、立ち絵の背景は白で統一します。
学習への利用をオフにする
ChatGPT・Gemini・Grok は、デフォルトでアップロードした画像や会話の内容を AI の学習に利用する設定になっています。今回は人のアバターの画像を渡すので、先に学習に使わない設定にします。
ChatGPT
- 左下のアカウント名から「設定」を開く
- 「データコントロール」を開く
- 「モデル改善に協力する」をオフにする
Gemini
「設定とヘルプ」の「アクティビティ」で「Gemini アプリ アクティビティ」をオフにすると学習には利用されなくなりますが、過去の会話の履歴も一覧に表示されなくなります。そのため、アクティビティはオンのままにして、人の画像を扱うときだけ一時チャットを利用します。
- 画面右上の、点線の丸で囲まれたペンのアイコンを押す。カーソルを合わせると「一時チャットをオンにする」と表示されます
- そのまま入力欄から利用する
Grok
Grok と X は設定が別々で、片方をオフにしても、もう片方には反映されません。使う方で設定します。
- grok.com: 「設定」→「データコントロール」を開き、「モデルを改善」をオフにする
- X: 設定の「プライバシーと安全」を開き、「データ共有とカスタマイズ」の「Grokとサードパーティコラボレーター」を開いて、「公開データに加えて、GrokおよびxAIでのやり取り、インプット、結果をトレーニングと調整に利用することを許可します」のチェックを外す
PixAI
PixAI は、プライバシーポリシーに「明示的な同意なしに、アップロードした画像を基盤モデルの学習や改善に利用しない」と書かれています(2026年10月時点)。
ComfyUI
ComfyUI は自分の PC の中で画像を生成するので、外部のサービスで生成する API ノードを使わない限り、渡した画像やプロンプトが外部に送られることはありません。設定は不要です。
キャラデザ
何もないところから自分のアバターを用意する場合は、どんなキャラクターにするかを考えるところから始まります。性別・モチーフ・年齢・髪型・目の色・体格など、決まっていることを AI に伝え、決まっていないことは AI に補ってもらいながら、好みのキャラクターになるまで壁打ちを繰り返すことになります。ここでは、その壁打ちの相手にどの AI が向いているかをざっくり比べます。
今回は元になる画像がありますが、それは次の「画像から再生成」で使います。ここでは頭の中にあるキャラクターの特徴を並べて伝える想定で進めます。キャラデザなので、背景は指定せず、ポーズも AI に任せます。
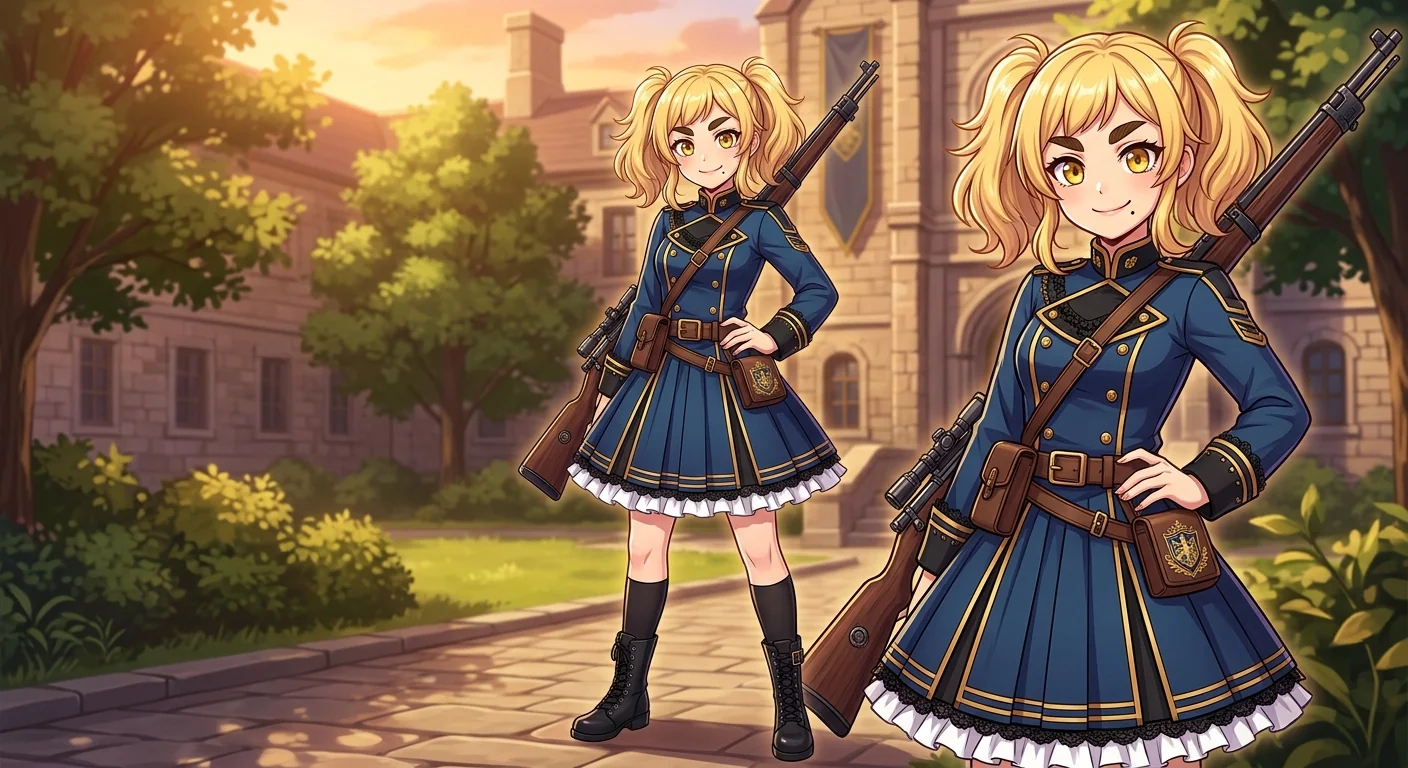
金髪、ハーフツイン、金色の目、麻呂眉、口元右にホクロ、ティーン、軍服ワンピース、背中にライフルという特徴を挙げて出力させます。
ChatGPT
配信に使うアバターのデザインを考えています。 金髪、ハーフツイン、金色の目、麻呂眉、口元右にほくろ、ティーン、軍服ワンピース、背中にライフルという特徴を持つキャラクターの画像を出力してください。
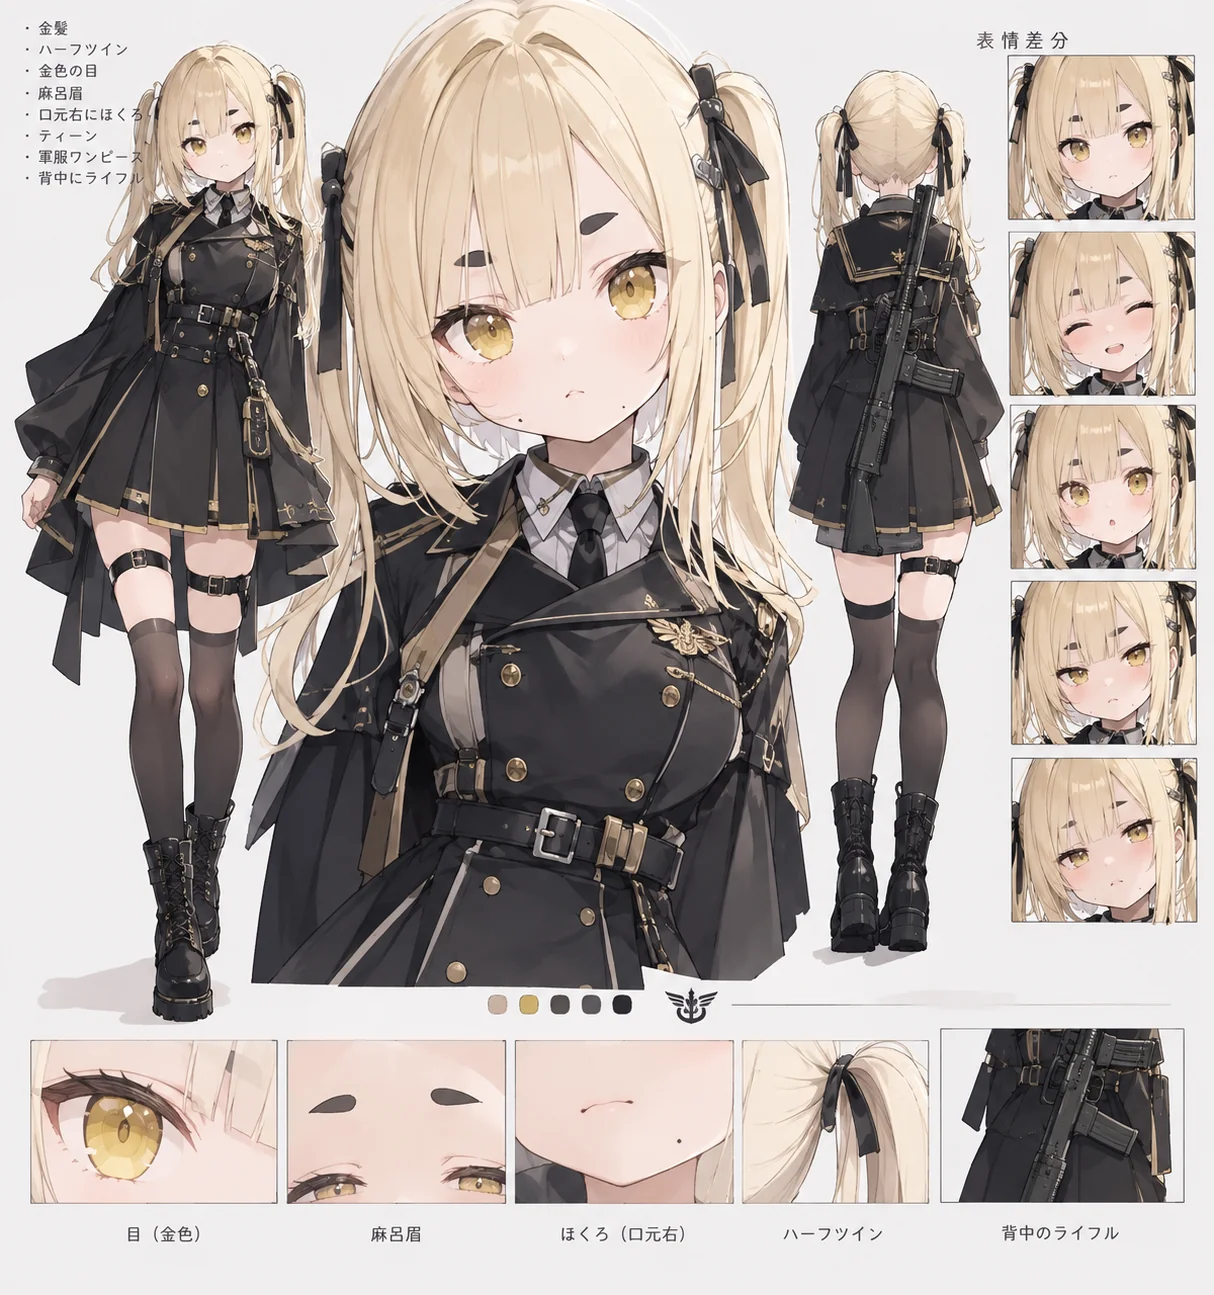
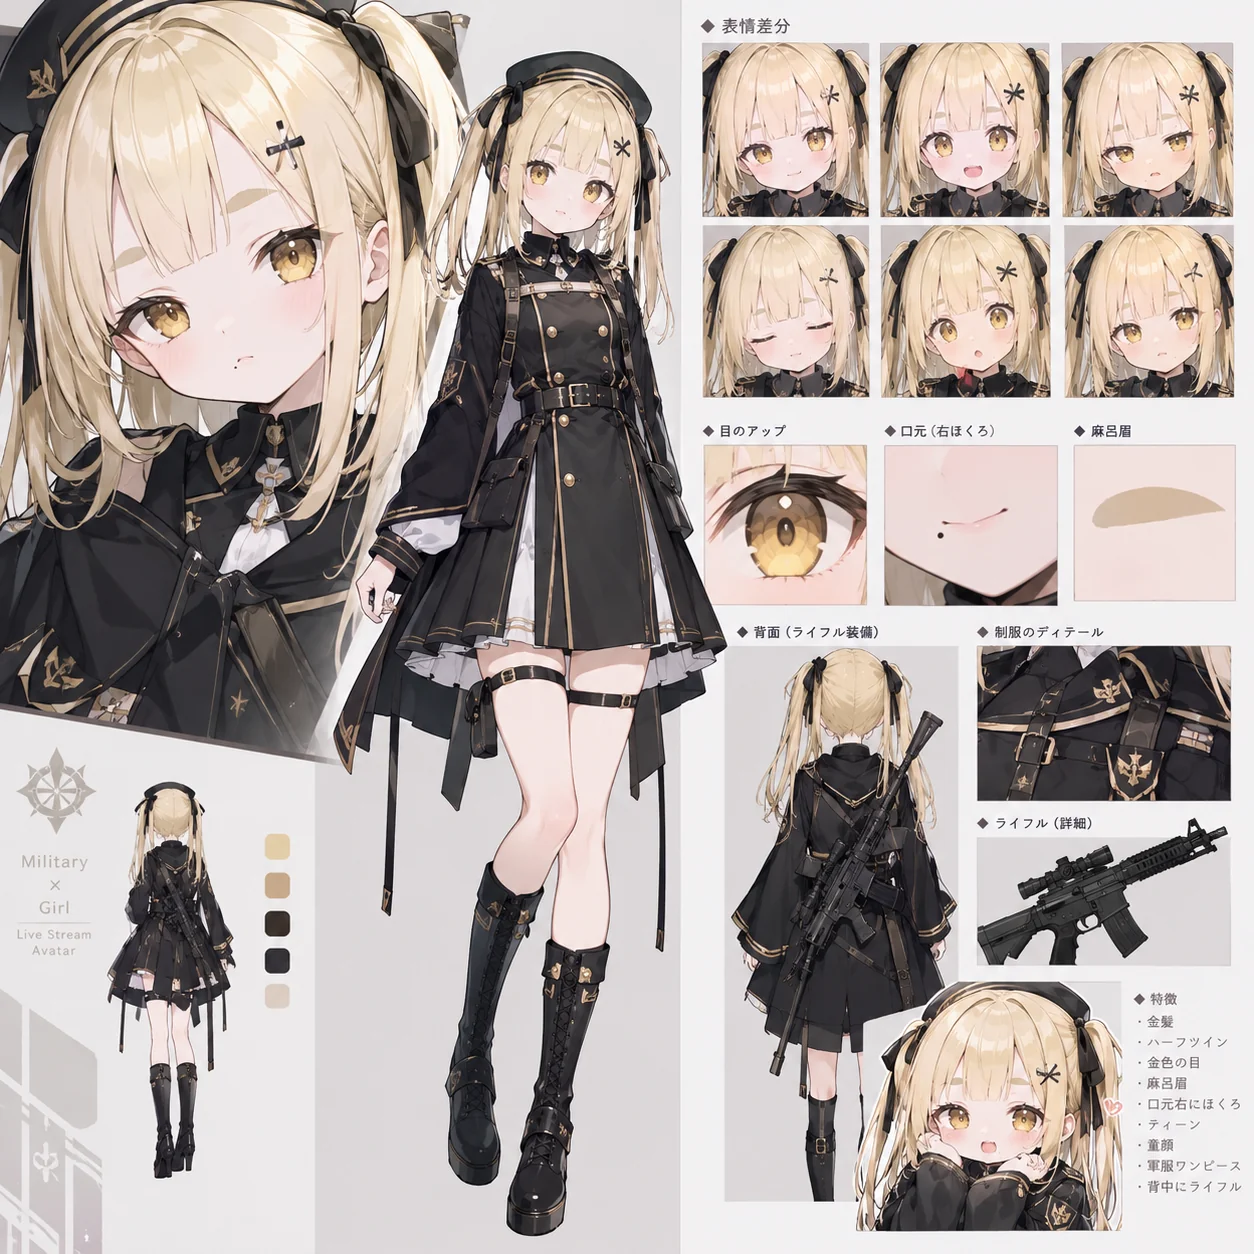
ハーフツインという髪型は安定しないのか、微かに後ろの毛も見える部分もありますがパッと見はほぼツインテールです。眉毛も色を指定した方がよさそうです。ホクロはあったりなかったり増えたりで安定しません。
顔つきが大人っぽくなったので、特徴に「童顔」を足してもう1枚出力させたら可愛らしい感じの仕上がりになりました。童顔という指定は可能ですが、年齢を指定すると 大変申し訳ございません。プロンプトの内容がコンテンツポリシーに違反している可能性があります。誤判定と思われる場合は、再度お試しいただくか、プロンプトを修正してください。 と怒られます。子どもが絡むといろんなものに NG を出しがちな ChatGPT。でも可愛い画像は出力してくれるので、露出の多いキャラクターを出力しないのであれば合格点ですね。
ChatGPT は割とすぐ1日の画像生成上限に引っ掛かってしまうので、何枚も生成したい人は課金した方が快適だと思います。翌日まで待てばいいだけなので個人的にはそんなに課金の必要性を感じていません。
Gemini
ChatGPT と同じ指示内容で出力しました。
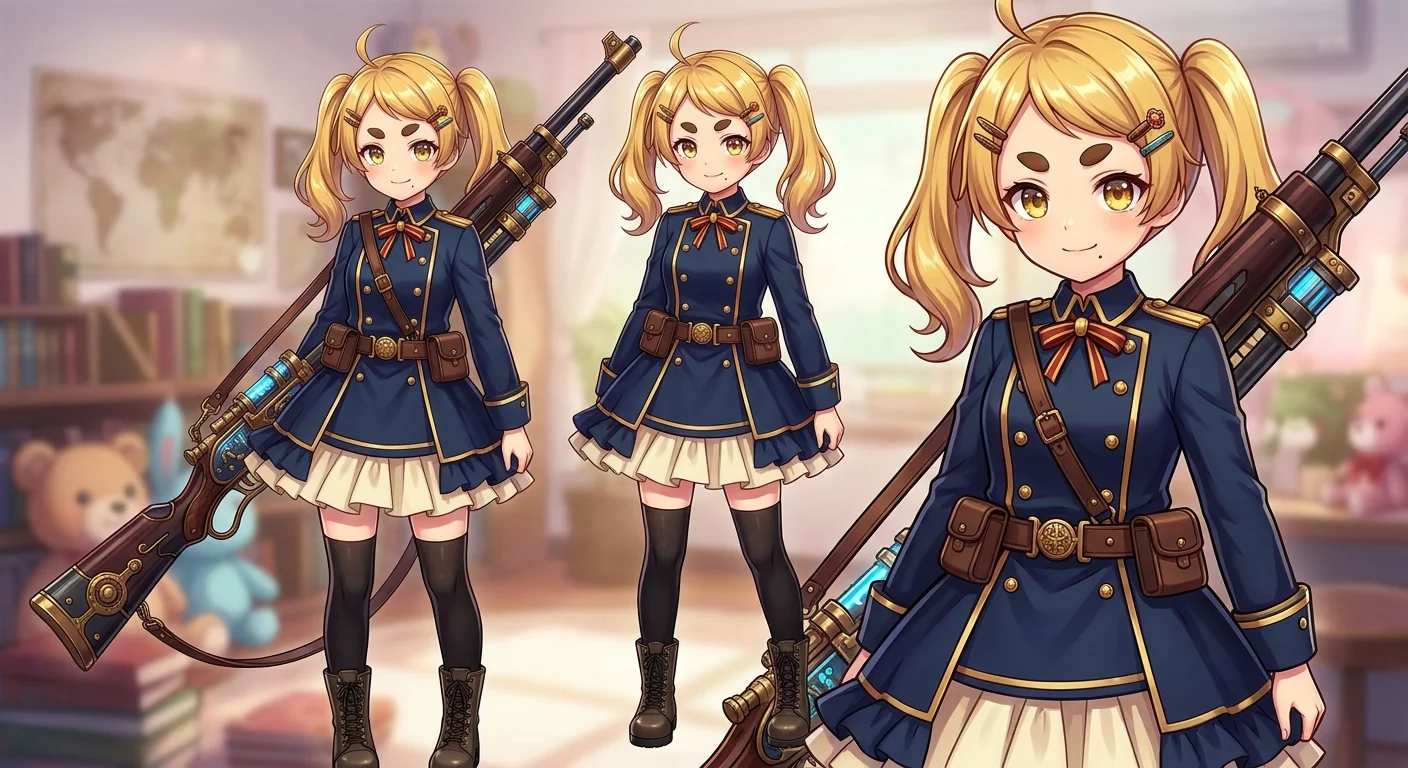
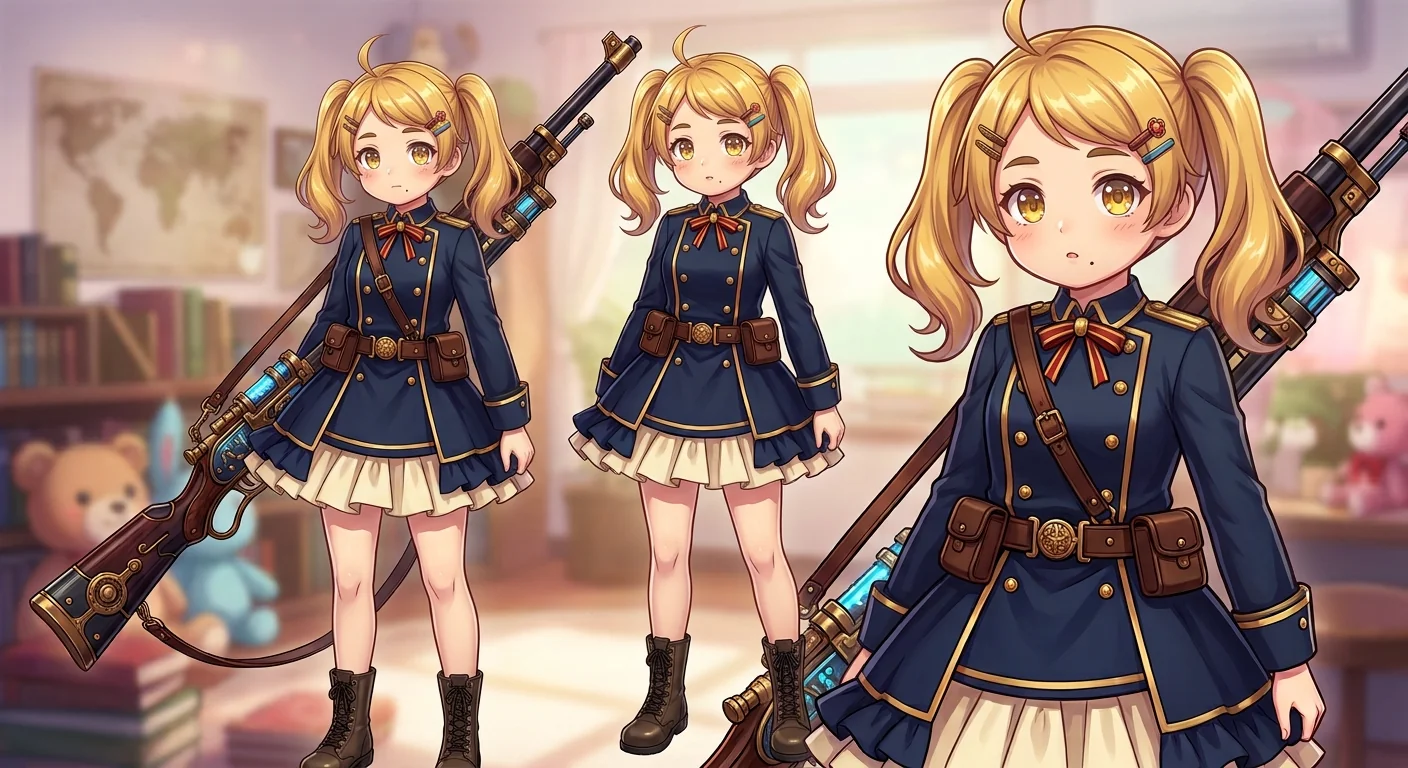
ChatGPT に比べるとあんまり可愛くないような…。ただこっちは年齢指定で NG にならないので、童顔の指示のあとに「7歳くらいにしてください」と追加指示したところ、かなり幼い顔つきで出力してくれました。ホクロも同じ位置でキープしています。指定したのは口元右なので、これはユーザーから見て右という認識になるようです。そしてこちらもハーフツインが通じなさそう。全部ツインテールじゃん。
まだ上を目指せると思うので ChatGPT に Gemini 用のプロンプトを用意させました。
アニメ・漫画風のオリジナルキャラクターを描いてください。
- 髪型・髪色: 金髪。左右の髪をそれぞれ結んだハーフツインテール。柔らかくふんわりした髪質。
- 目: 明るく輝く金色の瞳。
- 眉: 麻呂眉。眉尻がなく、眉頭寄りに短く独立した眉。
- 顔の特徴: 童顔で幼さの残る顔立ち。口元の右側に小さなほくろが一つある。
- 年齢・雰囲気: ティーンの少女。小柄で可愛らしい印象。
- 衣装: 軍服をモチーフにしたワンピース。黒やダークグレーを基調に、金色の装飾やボタン、ベルトなどを取り入れたデザイン。軍服らしい凛々しさと、少女らしい可愛らしさを両立させる。
- 武器: ライフルを背中に背負っている。
これらの特徴を満たす、魅力的で個性のあるキャラクターデザインにしてください。各要素が自然に調和するよう、細部のデザインや配色、髪飾り、衣装のシルエットなどは自由に考えて構いません。
ポーズ、表情、構図、背景、画風などは指定しません。キャラクターの特徴を大切にしながら、自由な発想で一枚のイラストとして完成させてください。
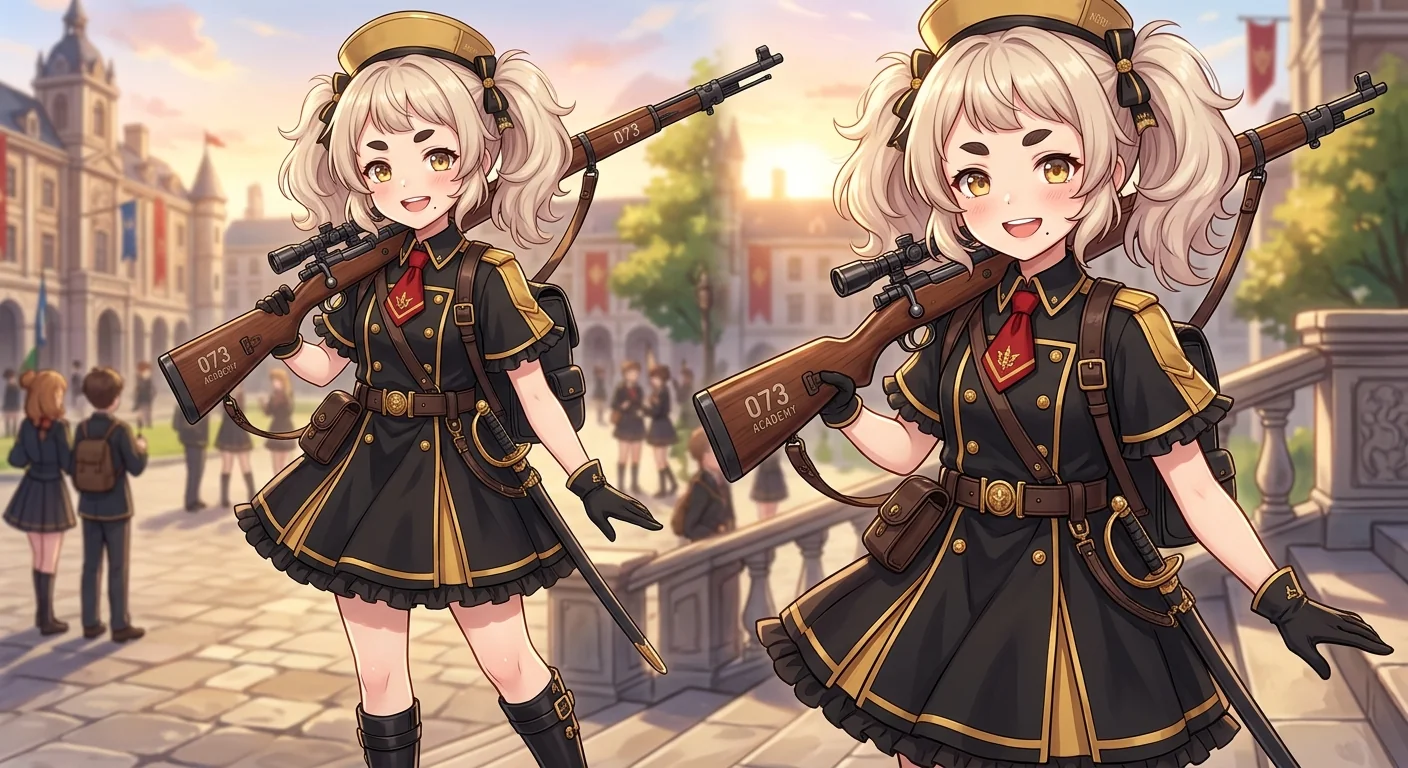
大差ないですね。この絵柄が好きな人ならこれでいいかもしれませんが…。
Gemini は画像形式が JPG なので、PNG に比べると拡大したときの画質の粗さも気になります。
Grok
ChatGPT と同じ指示内容で出力しました。実は Grok はほとんど使ったことがありません。一時期悪い意味で話題になっていたのでなんとなく避けてきました。
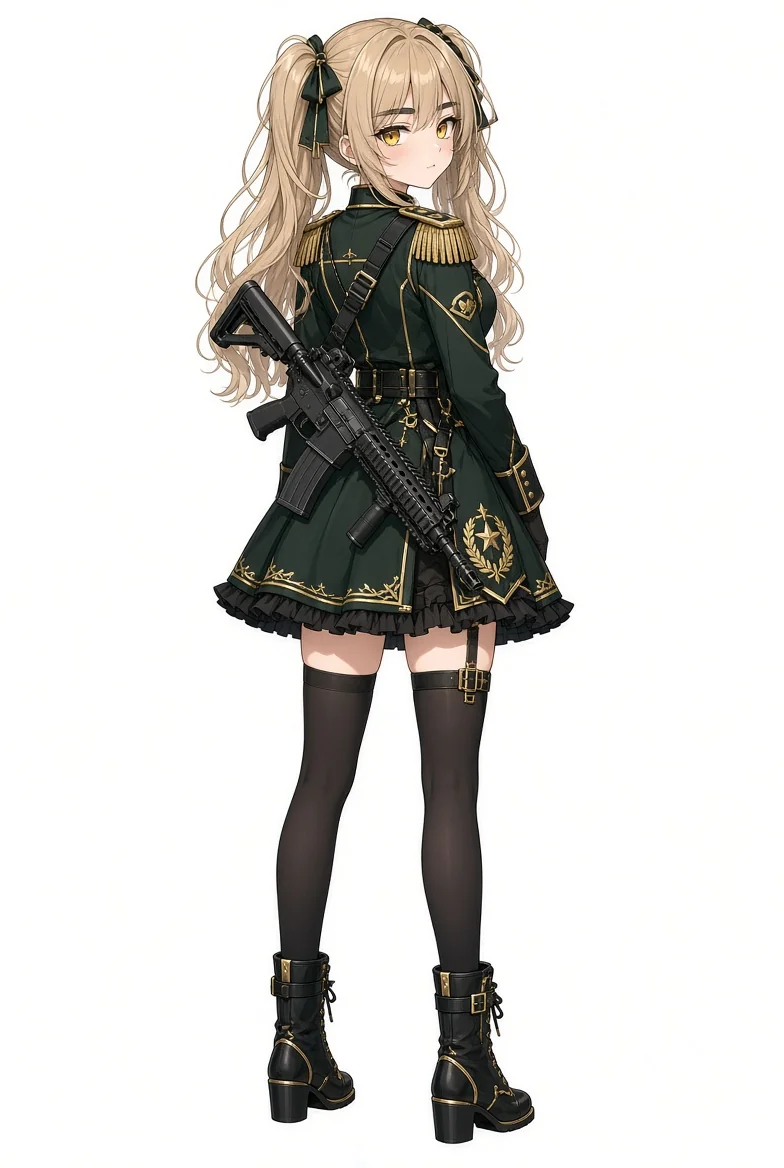
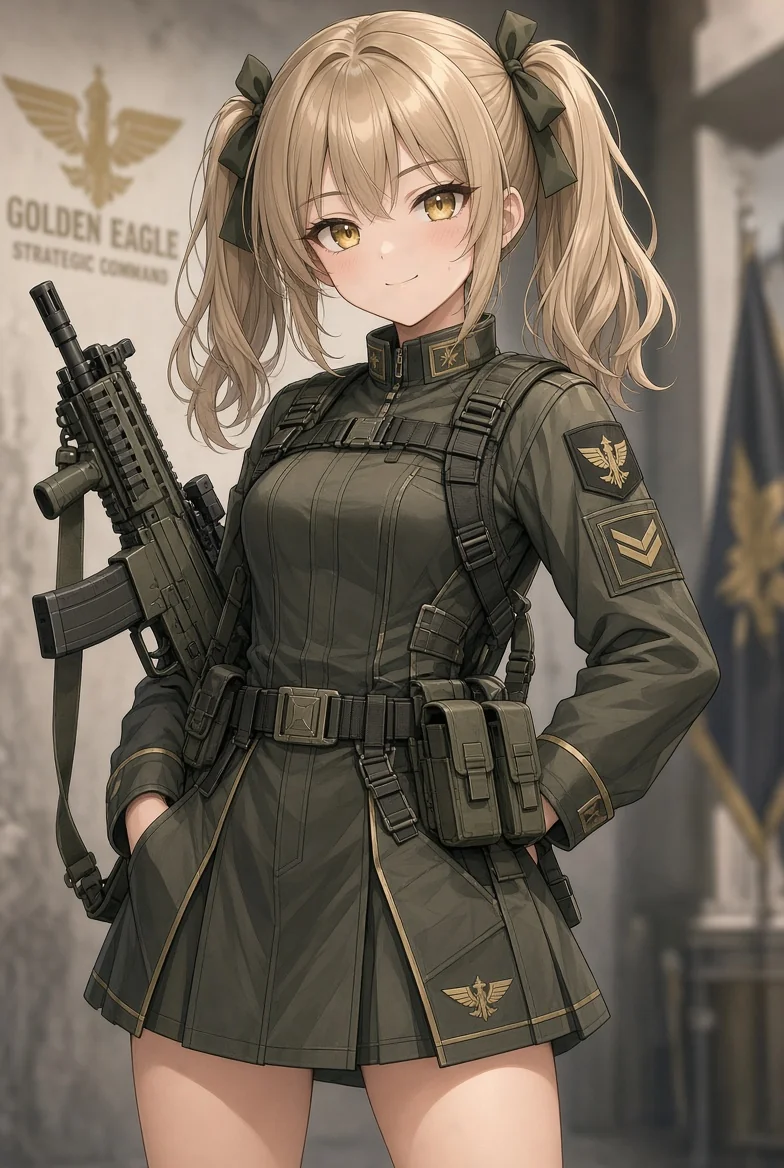
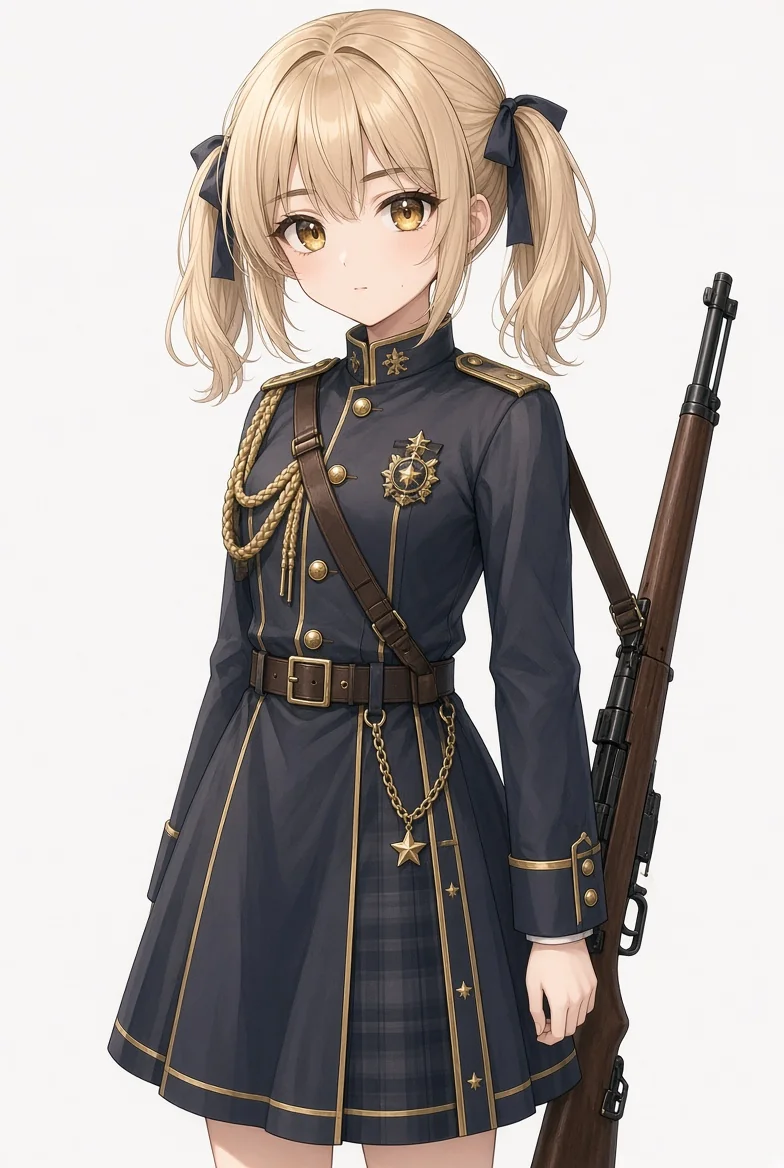
同じ指示でも服装の雰囲気が毎度変わりました。こちらもハーフツインが反映されません。麻呂眉も認識してなさそうです。ただの太眉やんけ。童顔の指示もほとんど影響を与えてなさそうですね。絵柄は ChatGPT に近いですかね。Grok は実写の方が得意と聞いていたので、期待していたよりは可愛い画像が出力されたと思います。
Gemini のときと同じように、ChatGPT に Grok 用のプロンプトを用意させました。grok.com の方で実行します。
オリジナルのアニメ風キャラクターを描いてください。
キャラクターの特徴
- 髪色は金髪。
- 髪型はハーフツインテール。左右の側頭部付近の髪をそれぞれ結び、残りの髪は自然に垂らしている。
- 瞳は明るく輝く金色。
- 眉は麻呂眉。眉尻のない、眉頭寄りに短く独立した眉。
- 口元の右側に小さなほくろが一つある。
- 年齢はティーン。童顔で、幼さの残る可愛らしい顔立ち。
- 衣装は軍服をモチーフにしたワンピース。黒やダークグレーを基調に、金色のボタンや装飾、ベルトなどを取り入れる。軍服らしい凛々しさと少女らしい可愛らしさを兼ね備えたデザイン。
- ライフルを背中に背負っている。
デザインの方針
上記の特徴を必ず反映し、統一感のある魅力的なキャラクターに仕上げてください。髪飾り、服の細部、装飾、色の配分などは自由にデザインして構いません。
ポーズ、表情、構図、背景、カメラアングル、画風などは指定しません。キャラクターの特徴を維持したうえで、自由な発想で一枚の完成度の高いイラストを生成してください。
キャラクター設定資料やデザインシートではなく、通常のキャラクターイラストとして描いてください。
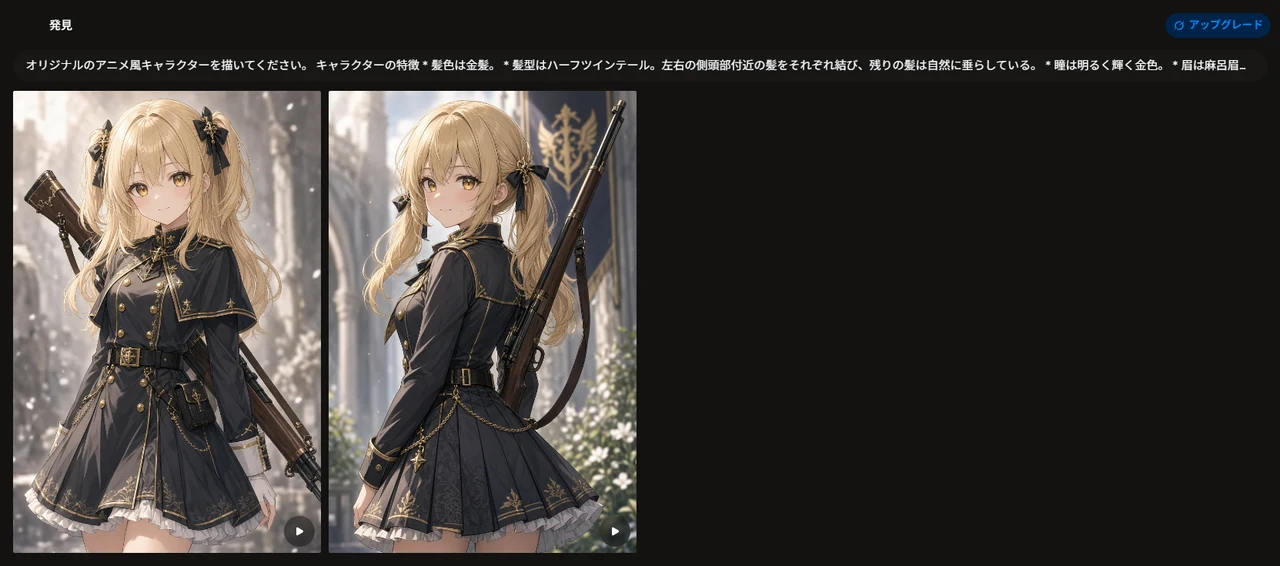
急にレベル上がりましたね。生成時に速度じゃなく品質優先にしたのも理由だとは思いますが。片方はちゃんとハーフツインになっています。
でもこの時点でもう画像生成の上限エラーが表示されてこれ以上の生成ができなくなりました。品質優先にしなかったらもう1回くらいできたかもしれません。
PixAI
PixAI は生成にポイントを消費するので、無課金で楽しみたい人は毎日ログインボーナスを受け取ってポイントの貯蓄をしておくといいです。トップページで人の生成した作品を見るだけでも楽しいので無意識に毎日一度は開いてます。画像を生成するために使ったプロンプトや LoRA を公開している人もいるので、好みの絵柄がどうやって出力されたのかも確認できます。
ここからは同じプロンプトは使えないので、画像生成用の呪文を用意します。どのモデルを使うかでかなり出力に差が出ると思うので、検証としては微妙かもしれません。
あとで参考画像を渡すことを考慮して、モデルは Haruka v2 を使います。公式が今推してるモデルは Tsubaki シリーズなんですが、Tsubaki は参考画像を渡す欄がないんですよね。LoRA は使用せず、ポジティブプロンプトとネガティブプロンプトのみ渡して、他はデフォルト設定のまま生成します。
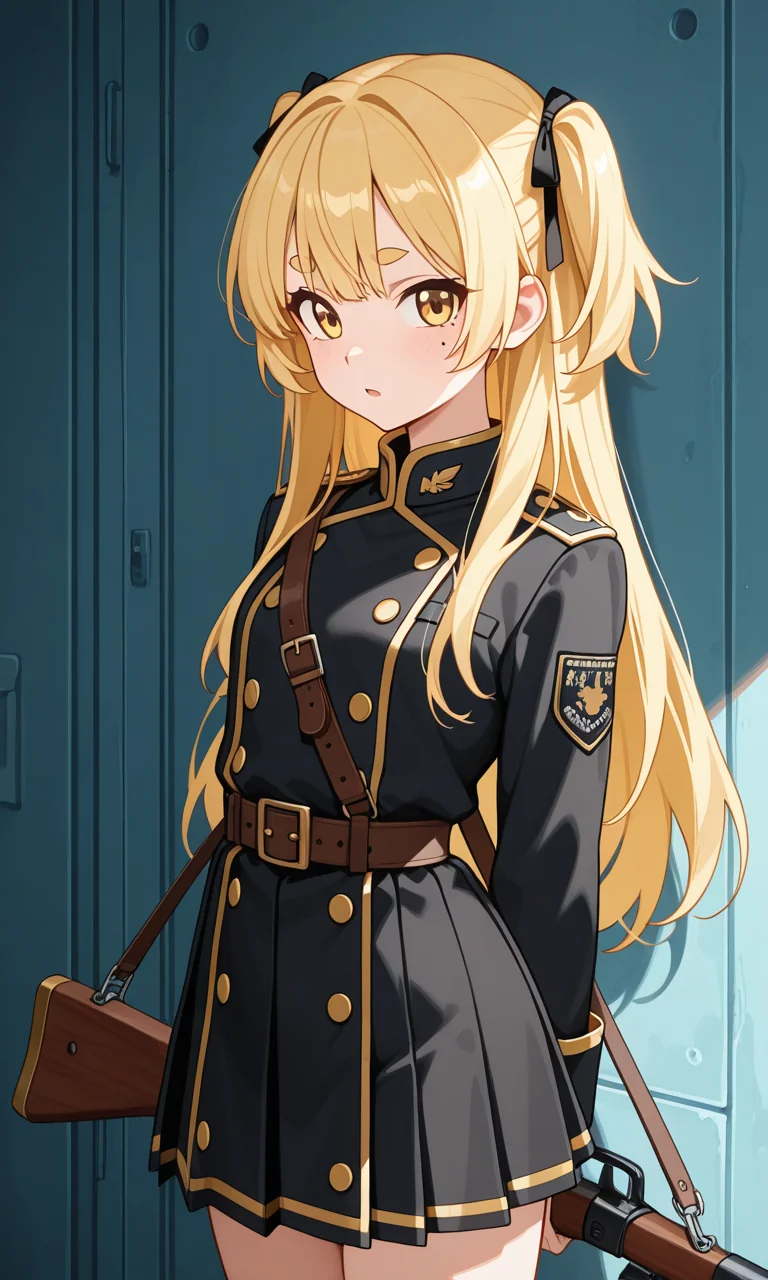
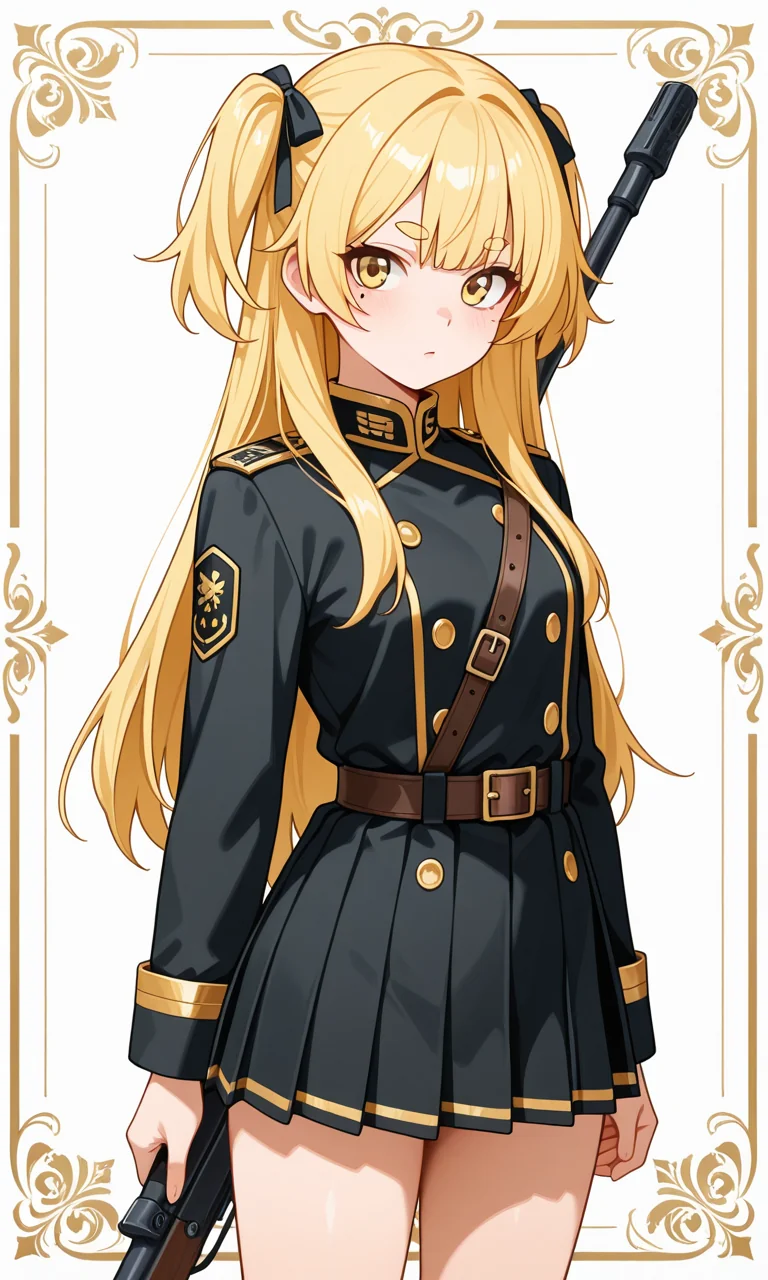
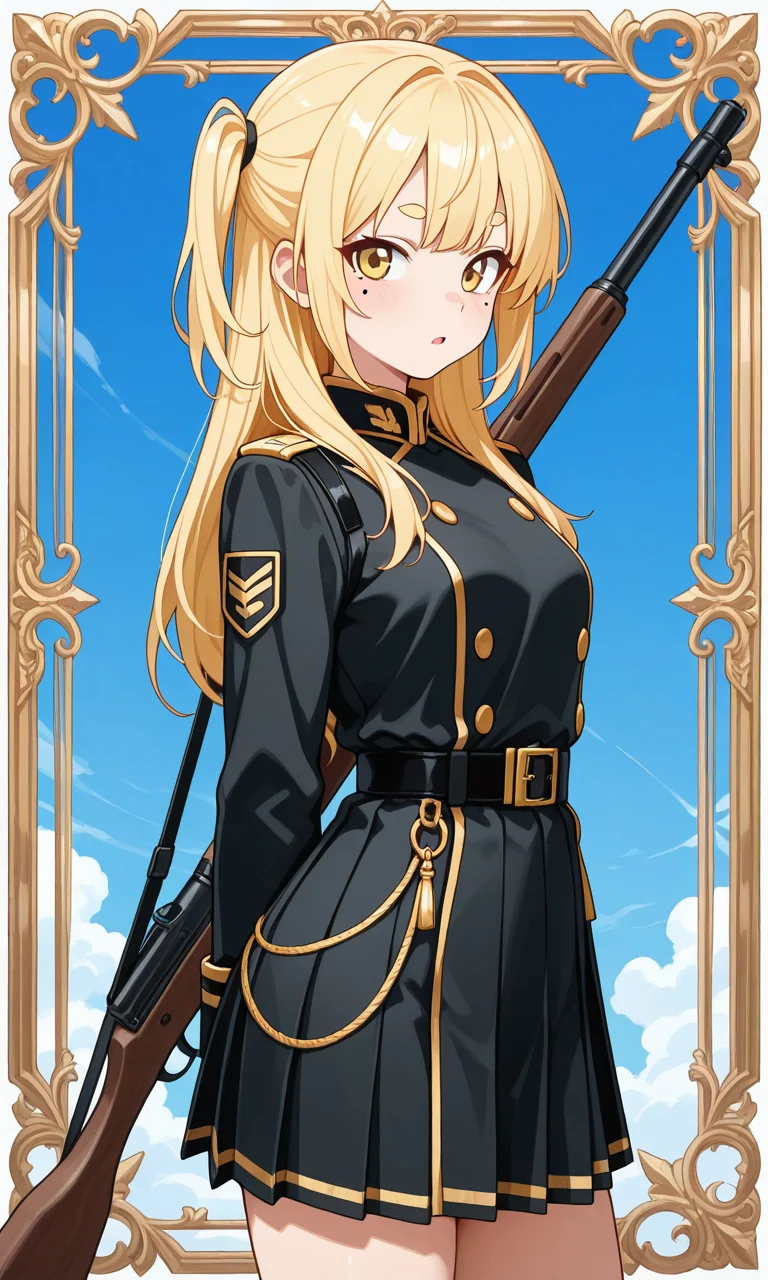
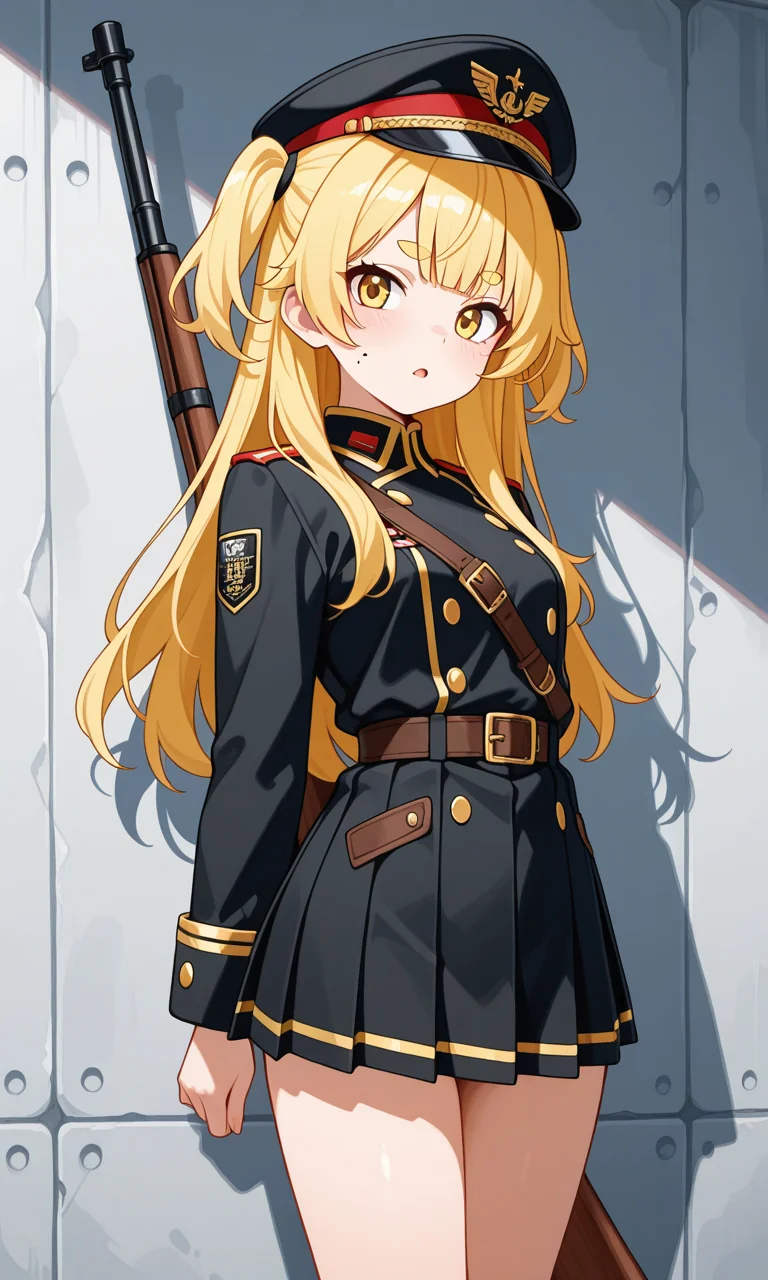
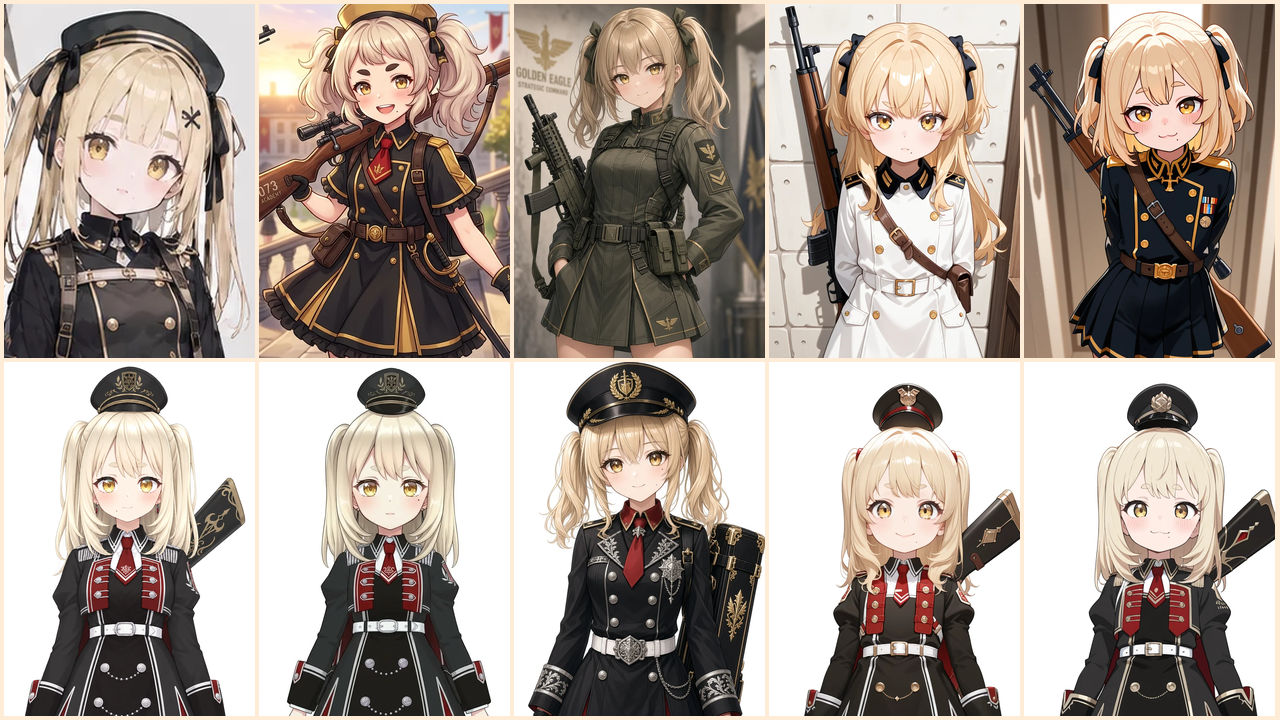
ホクロの位置はコントロールできていませんが、ハーフツインと麻呂眉という無視されやすい部分は安定して出力されています。でも麻呂眉とハーフツインを出すまでに何度かプロンプトの書き換えをしているので安定しているとも言い難い…。ということで敢えて日本語呪文で出力してみます。
ハーフツインだとどうも「おさげ」という認識になるようで三つ編みが追加されたので「ツーサイドアップ」とし、童顔と書くと赤子を抱っこするようになったので、童顔やティーンをやめて「子ども」にしました。
子ども、金髪、ツーサイドアップ、金色の目、麻呂眉、口元右にほくろ、軍服ワンピース、背中にライフル
ネガティブプロンプトはなしで。
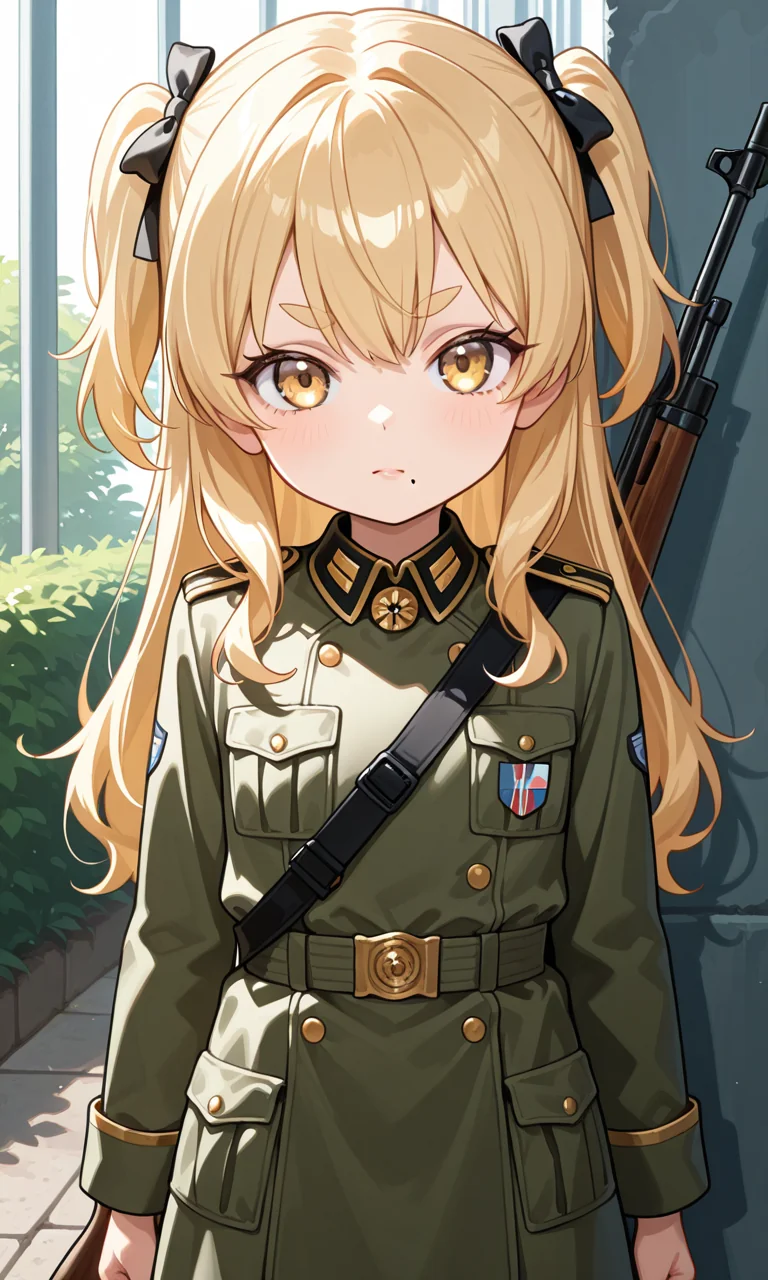
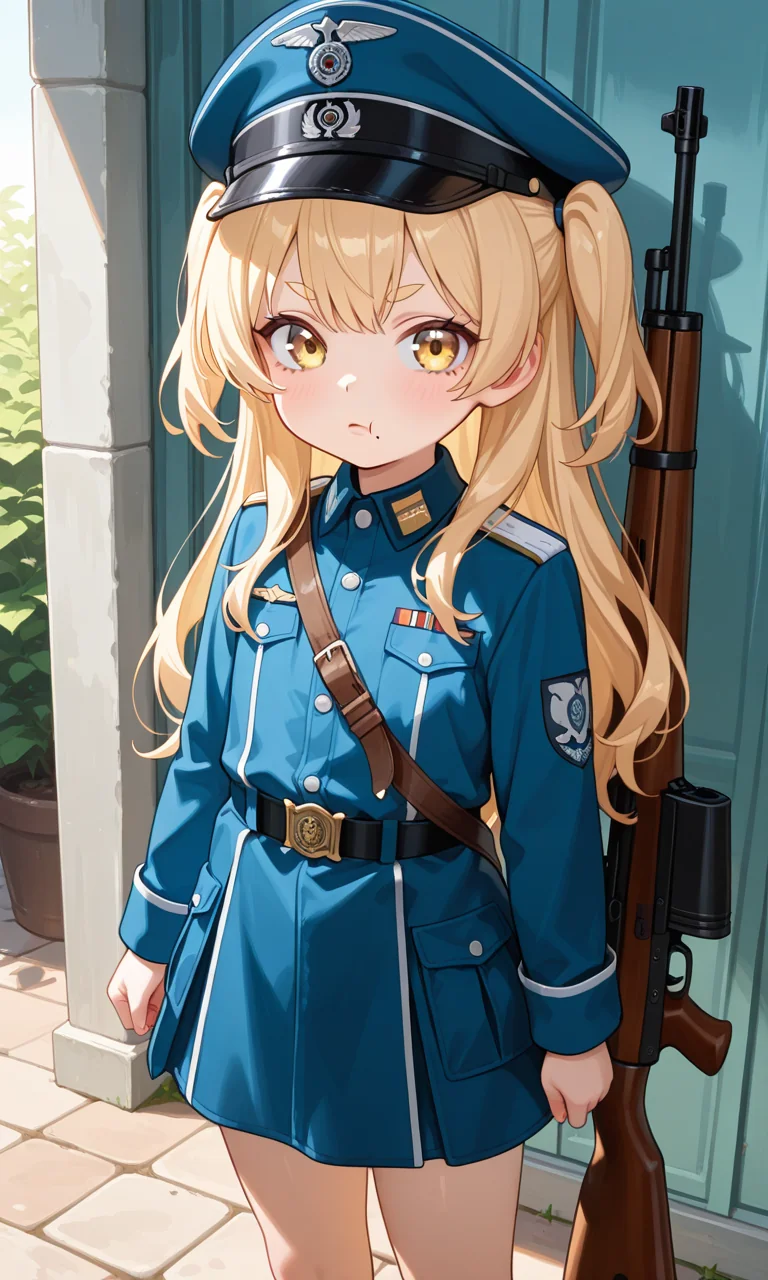
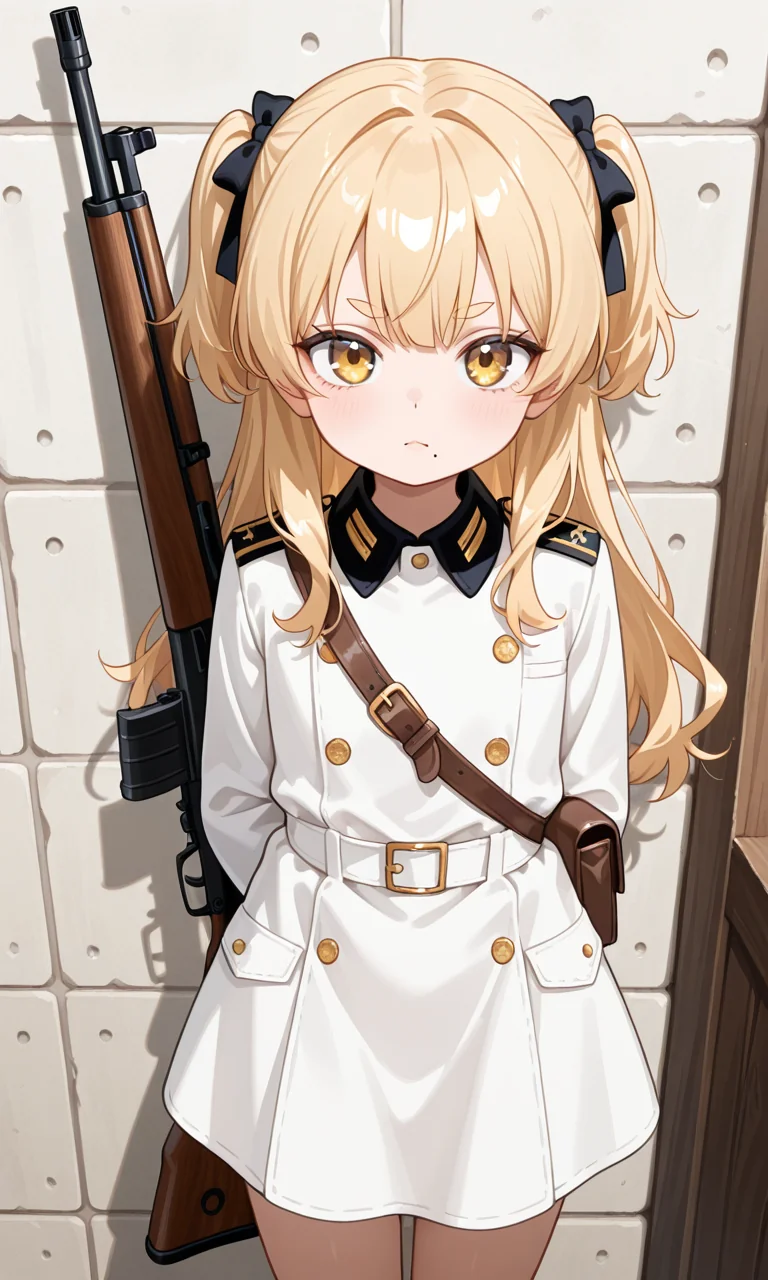
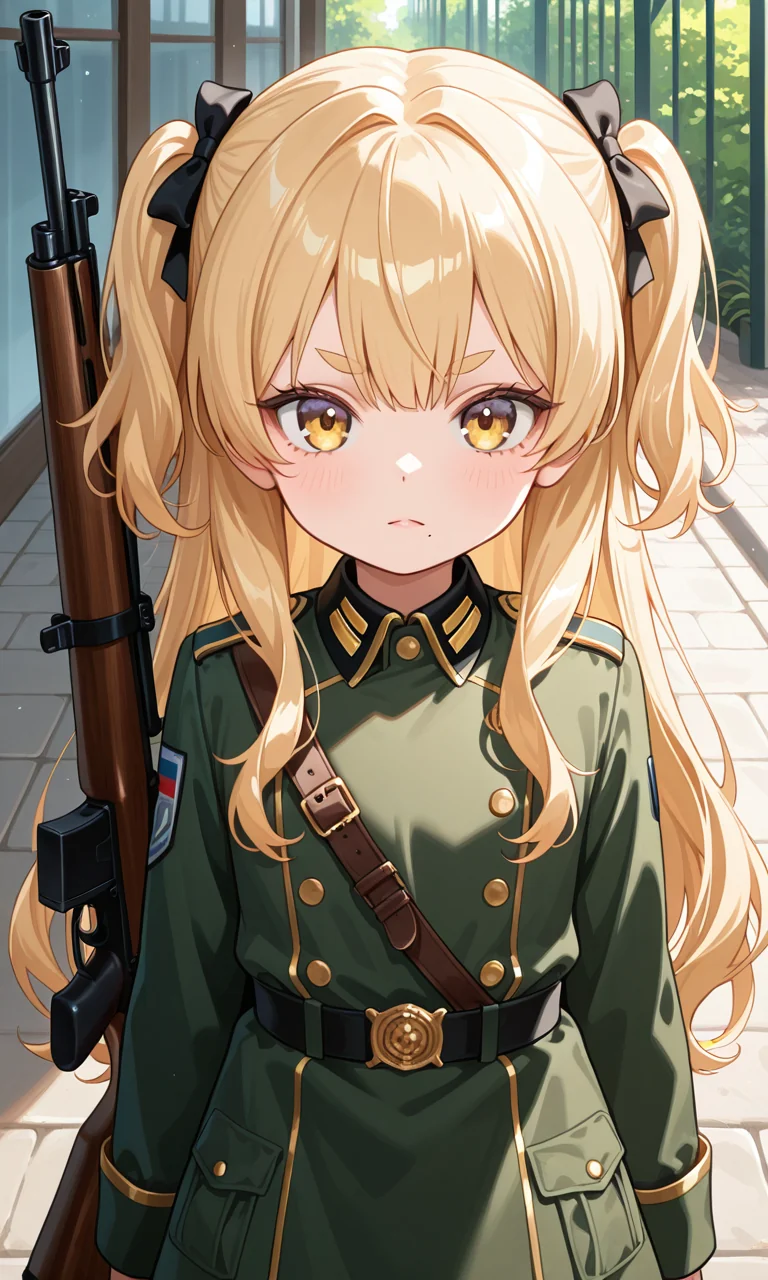
出るやん…日本語プロンプトでよかったんや…。そういや生成を開くと入力欄のプレースホルダに日本語で「桜の木の下で本を読む少女」みたいな日本語の例が入ってましたね。PixAI は日本法人が東京にあるので、日本語ページの運営は日本でされてるようです。日本語呪文は自動的に変換されてるっぽいですね。
ComfyUI
ComfyUI の導入手順は、こちらにまとめています。
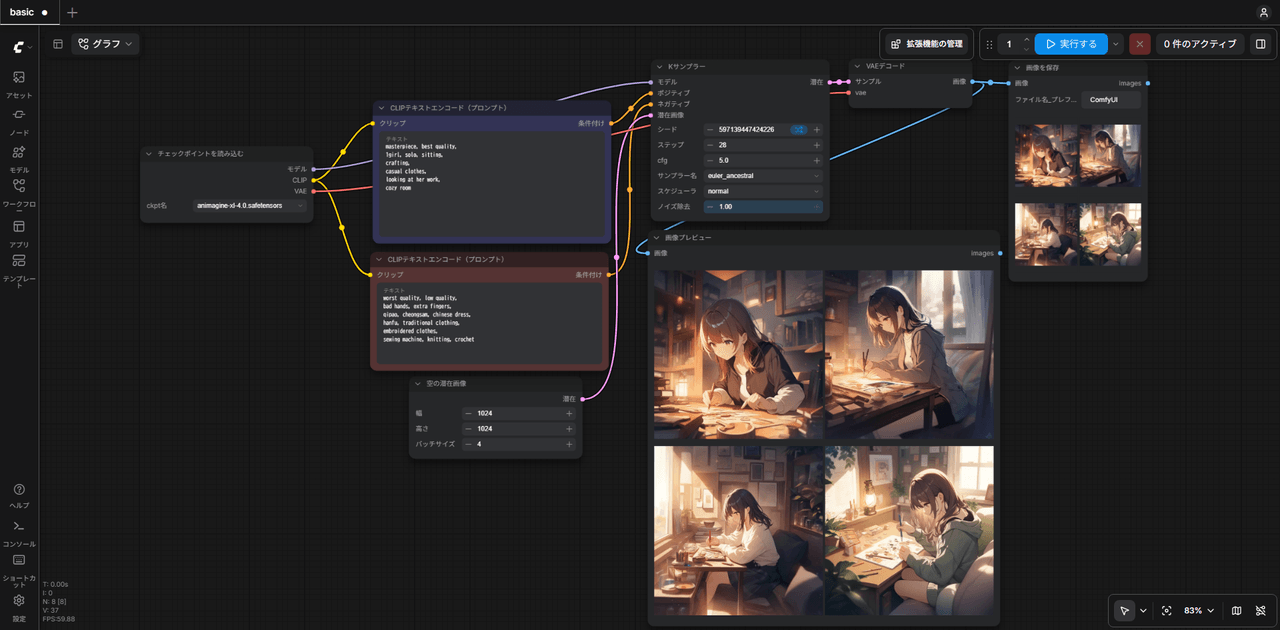 自分のPCにAI画像生成環境を構築する手順 Windows の PC に ComfyUI を入れて AI 画像生成を始めるまで。導入の 2通りの方法、モデルの選び方とライセンス、ノードの組み方まで。
こっちはさすがに日本語呪文が使えないので再度プロンプトからやり直します。モデルは WAI-illustrious-SDXL v16 です。v17 が出たそうですがアプデしていないのでこの記事の中では v16 のままでいきます。微調整した結果こうなりました。
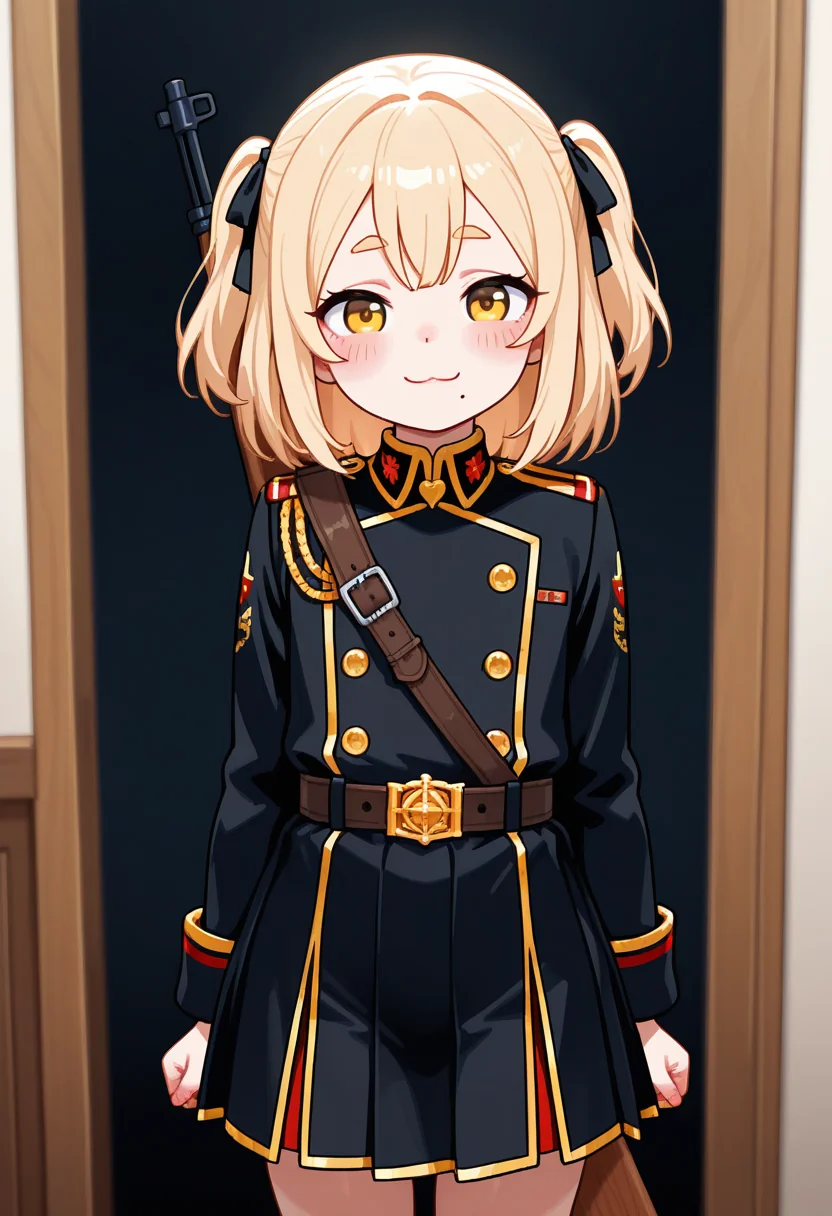
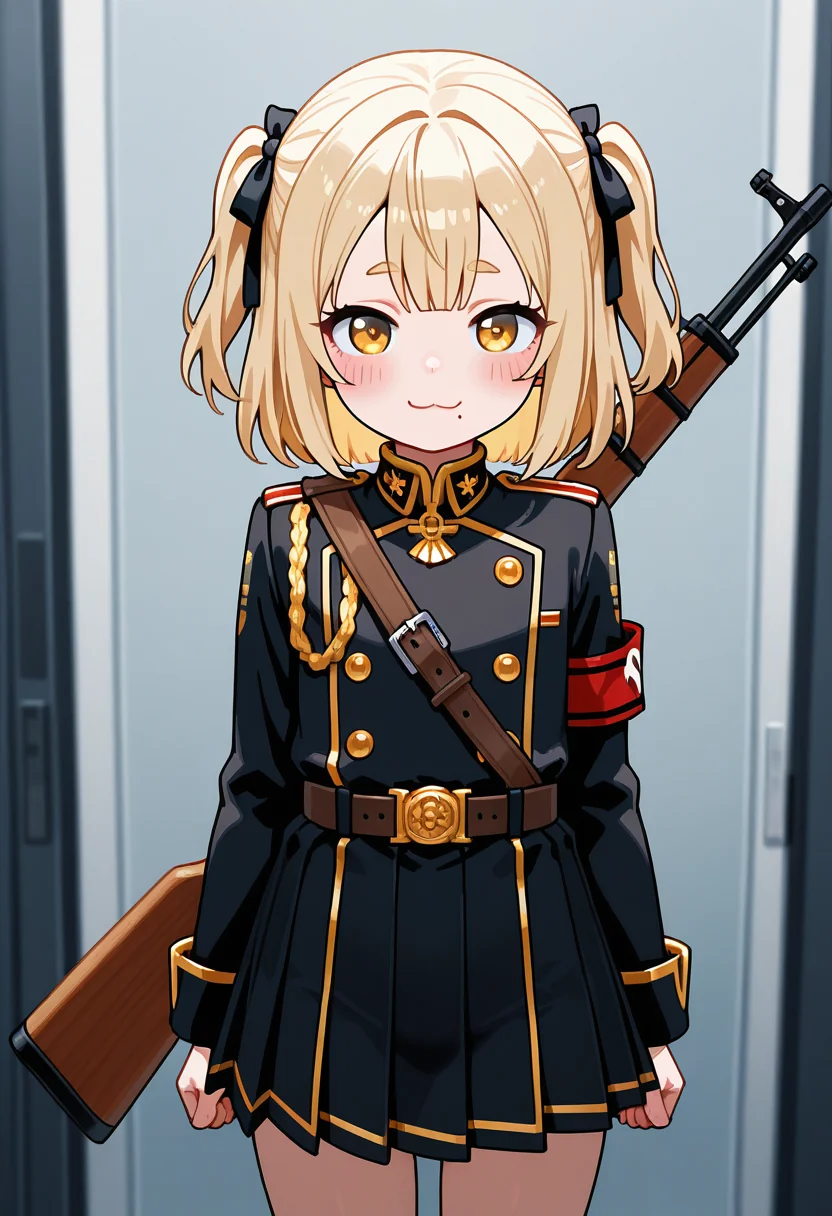
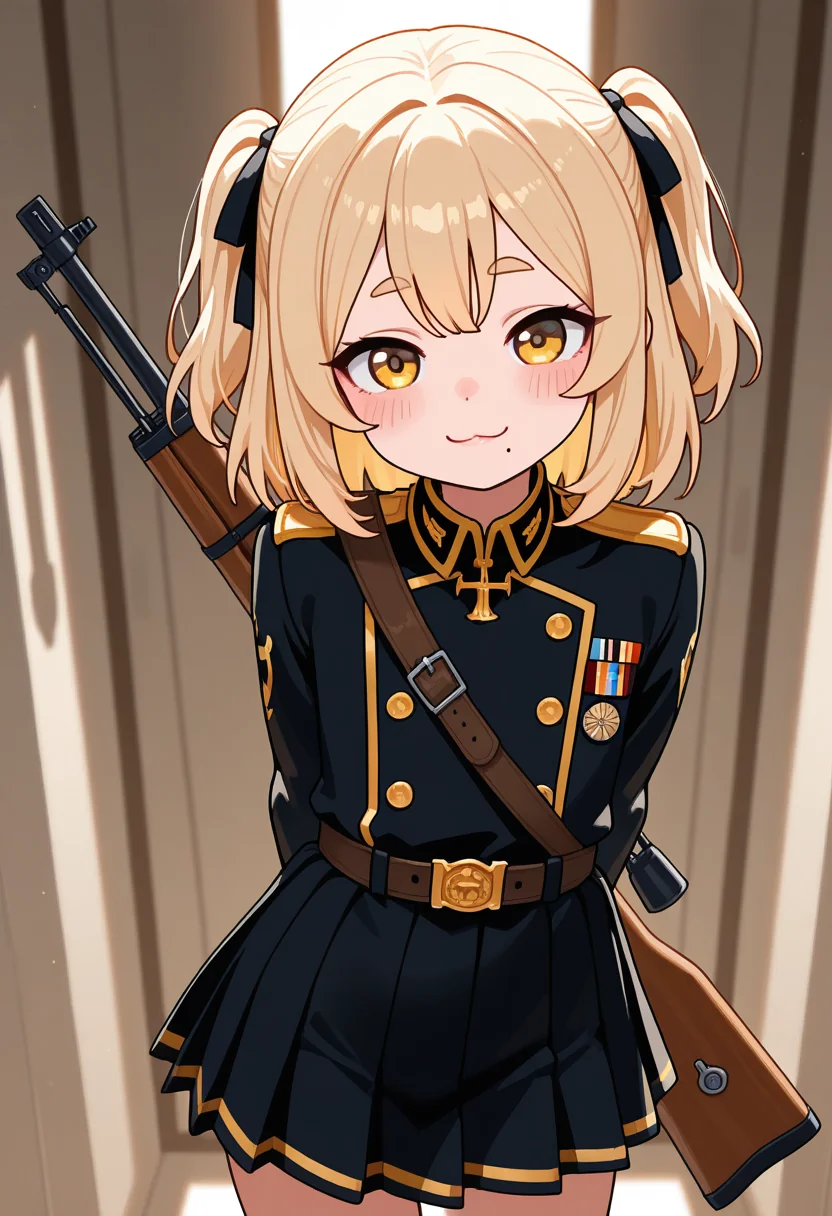
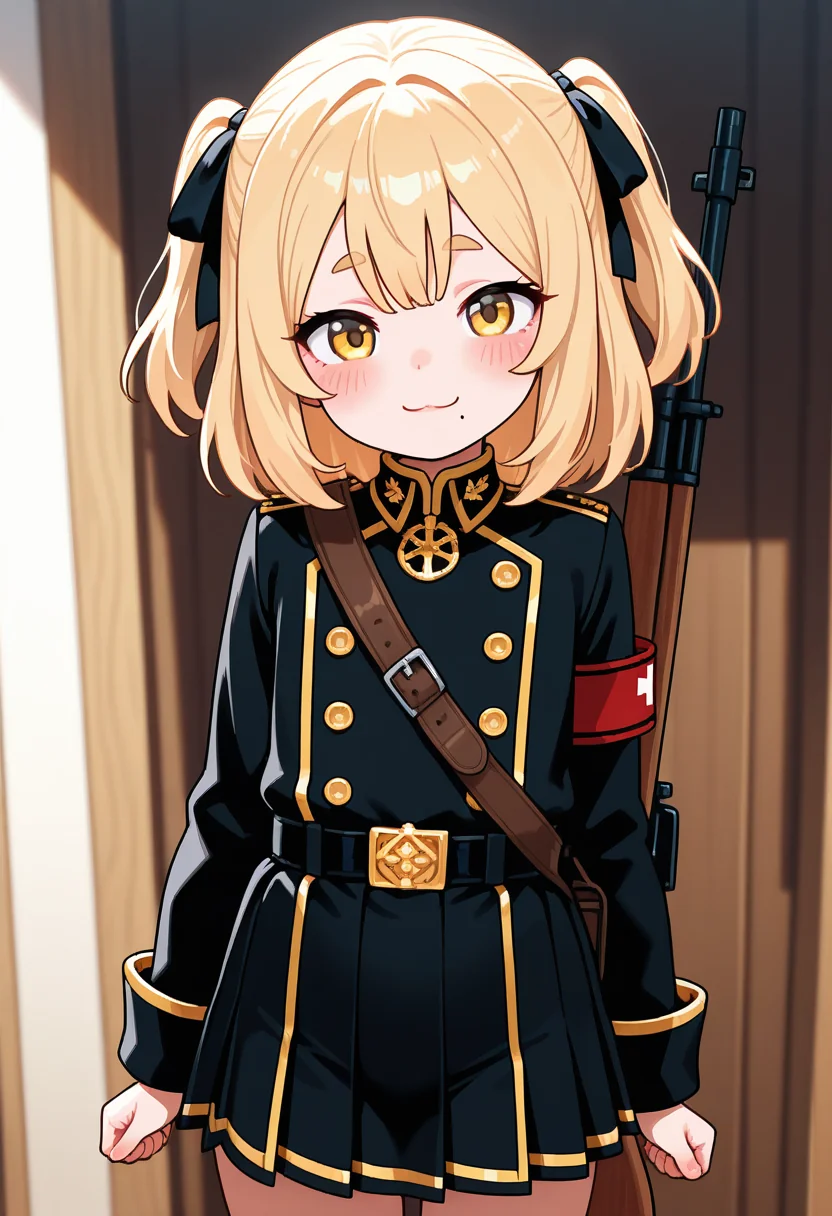
エロ画像にならないように sfw を指定しています。ハーフツインは髪の長さを指定しないとロングになるので、ミディアムヘアを指定しました。あんまり細かく指定すると趣旨から離れるので一旦ここでやめておきます。
PixAI の日本語プロンプトも髪の長さや表情の指定をすれば似た感じの出力になったと思います。
キャラデザのまとめ
| AI | よかったところ | 気になったところ |
|---|---|---|
| ChatGPT | 適当な指示でも可愛い画像を出力してくれる | ハーフツインやホクロが安定しない。年齢を指定するとコンテンツポリシーで断られる。1日の画像生成上限にすぐ引っ掛かる |
| Gemini | 年齢を指定しても断られない。ホクロの位置が維持される | ChatGPT に比べるとあまり可愛くない。ハーフツインが通じない。ChatGPT に書かせたプロンプトでも大差ない。JPG なので拡大すると画質が粗い |
| Grok | ChatGPT に書かせたプロンプトで grok.com から品質優先で出力すると質が上がり、ハーフツインも出た | 同じ指示でも服装の雰囲気が毎回変わる。麻呂眉や童顔の指示が効かない。1日の画像生成上限にすぐ引っ掛かる |
| PixAI | 日本語のプロンプトでほぼ指示通りのものが出力できた | 英語のプロンプトではハーフツインと麻呂眉を出すまでに何度か書き換えが必要。ホクロの位置はコントロールできない。無料だがポイントを消費する |
| ComfyUI | ミディアムヘアを指定するとハーフツインが出た | 日本語のプロンプトは使えないので、英語のプロンプトを微調整する必要がある |
画像から再生成
参考画像を渡して配信用アバターを生成します。
ChatGPT
この女の子をモデルに、PNGTuber 用の立ち絵を出力してください。 髪型・目の色・服装・ほくろの位置は画像に合わせて、アニメ調の可愛いイラストにしてください。 腰から上を正面から、目を開けて口を閉じた表情で、手は自然な位置に下ろしてください。 文字は入れず、背景は白にしてください。
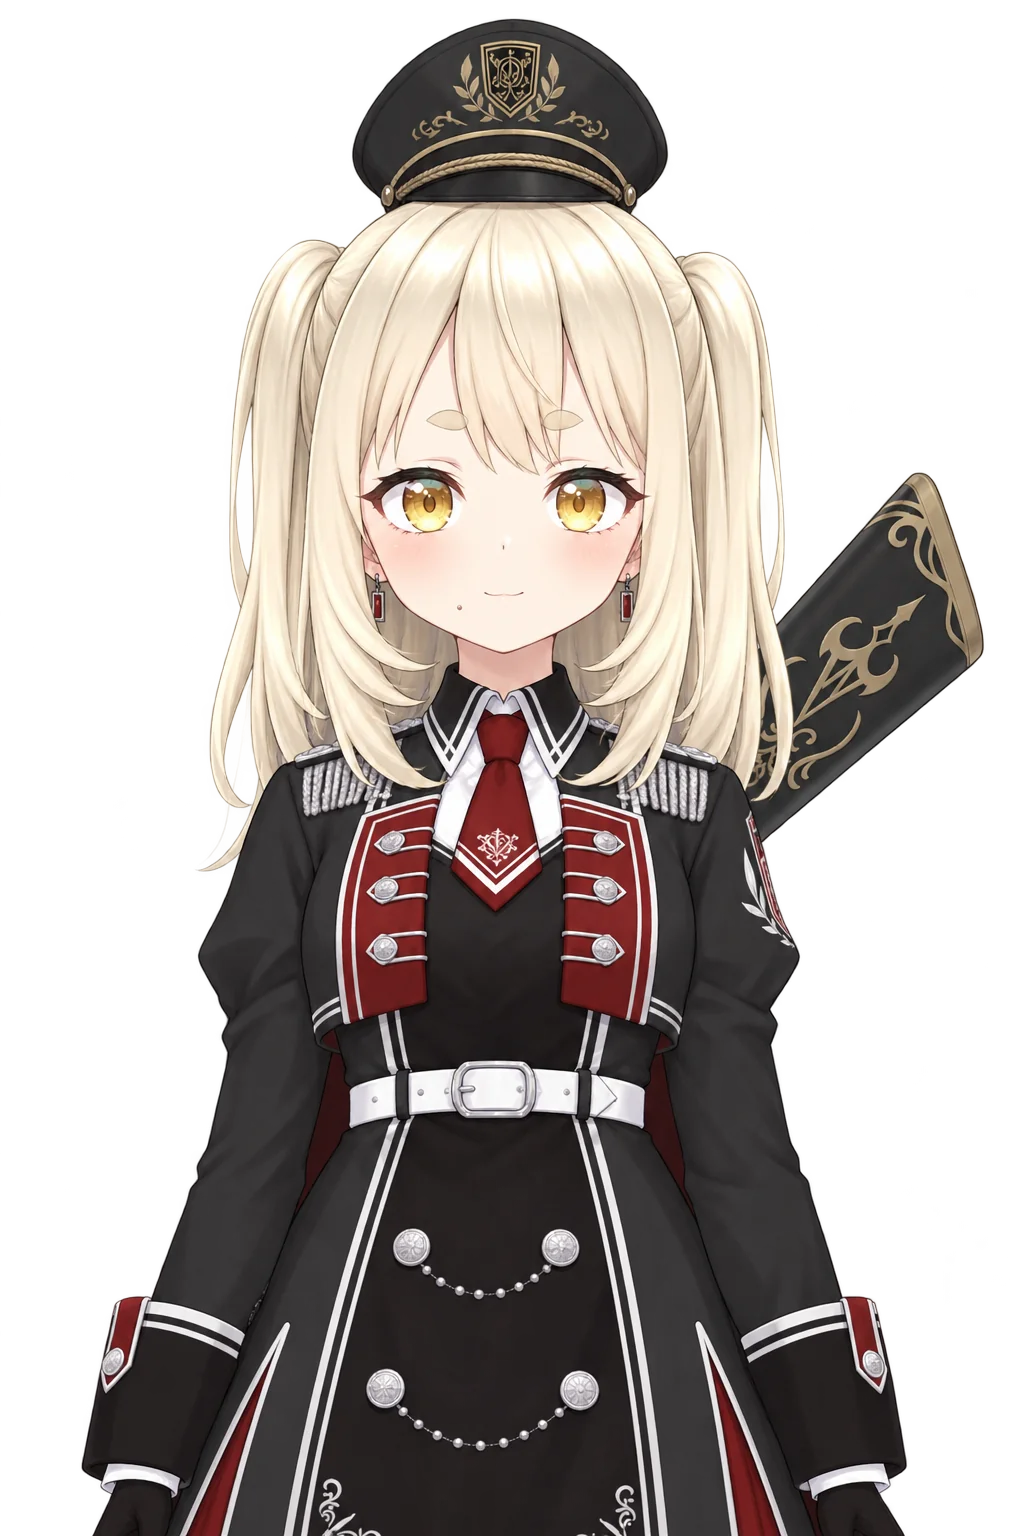
背景白でと指示したのに透過された状態で出力されました。え?アプデで背景透過画像の生成精度あがった?以前は背景を透過したら画像がガビガビになってましたが、なんかいい感じに出力してくれました。これで差分も同じように出力してくれるなら手動で透過する手間がなくなりますね。
Gemini
ChatGPT と同じ指示をして画像を渡します。
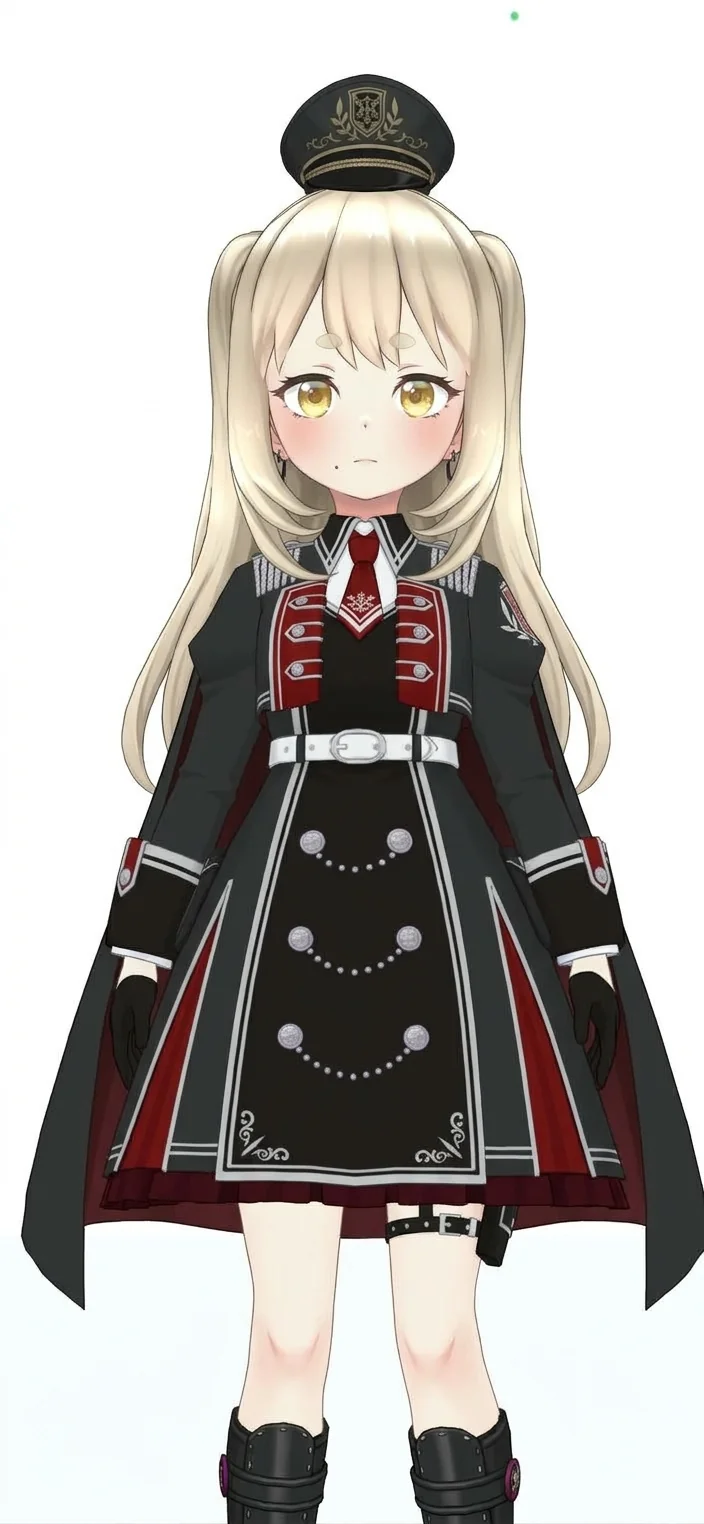
全然ダメですね。髪を伸ばし、ライフルを除去した以外ほぼそのままです。ChatGPT と同じ指示ではダメなので指示を少し変えます。
この女の子をモデルに、PNGTuber 用の立ち絵を出力してください。 画像は 3D モデルなので、見た目はそのまま使わず、特徴だけ参考にして 2D のアニメイラストとして描き直してください。 線画があって、塗りは日本のアニメ風の、可愛いイラストにしてください。 髪型・目の色・服装・ほくろの位置は画像に合わせてください。 腰から上を正面から、目を開けて口を閉じた表情で、手は自然な位置に下ろしてください。 文字は入れず、背景は白にしてください。
この女の子をモデルに、PNGTuber 用の立ち絵を出力してください。 画像は 3D モデルなので、見た目はそのまま使わず、特徴だけ参考にして 2D のイラストとして描き直してください。 アニメのセル画ではなく、pixiv やソーシャルゲームの立ち絵のような、描き込みの多い可愛いイラストにしてください。目はハイライトとグラデーションで細かく描き、髪や服には柔らかい陰影を付けてください。 髪型・目の色・服装・ほくろの位置は画像に合わせてください。 腰から上を正面から、目を開けて口を閉じた表情で、手は自然な位置に下ろしてください。 文字は入れず、背景は白にしてください。
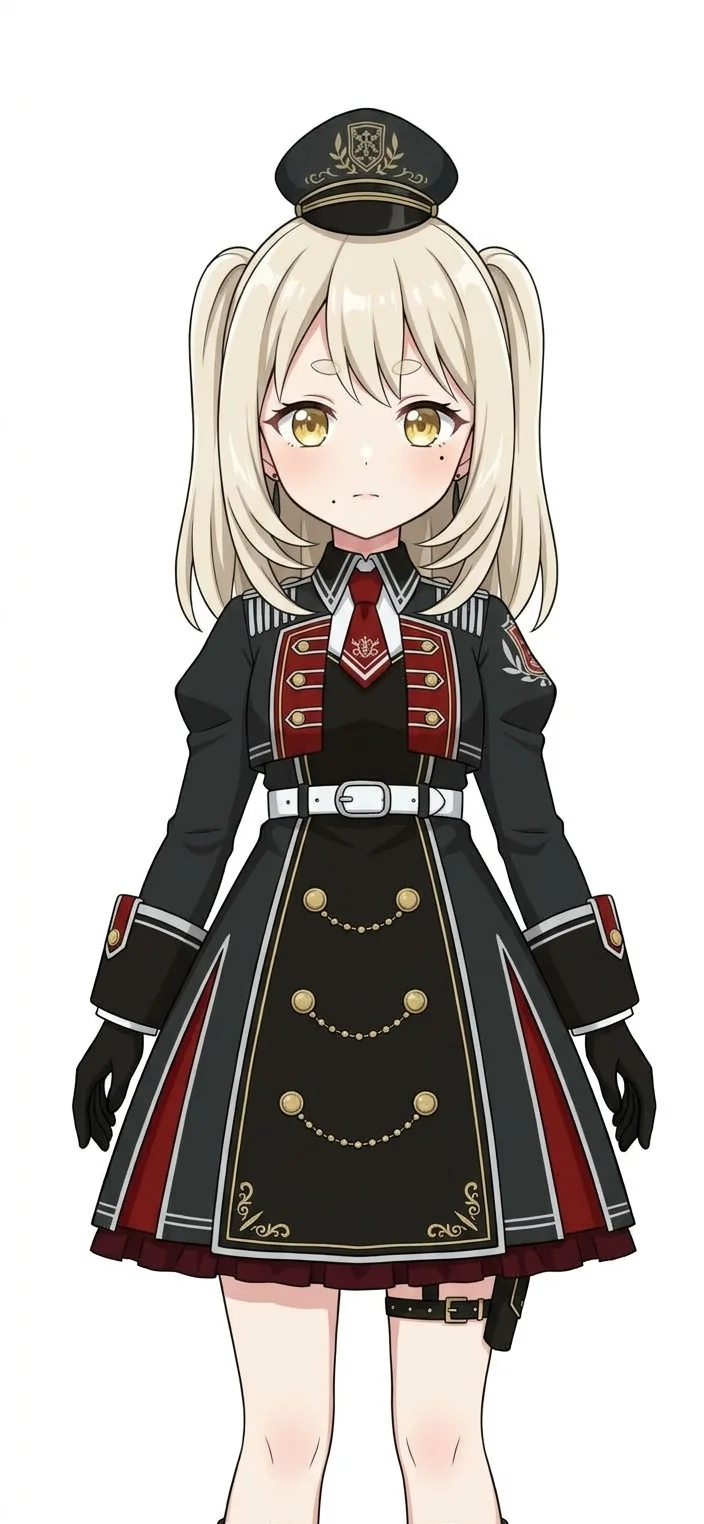
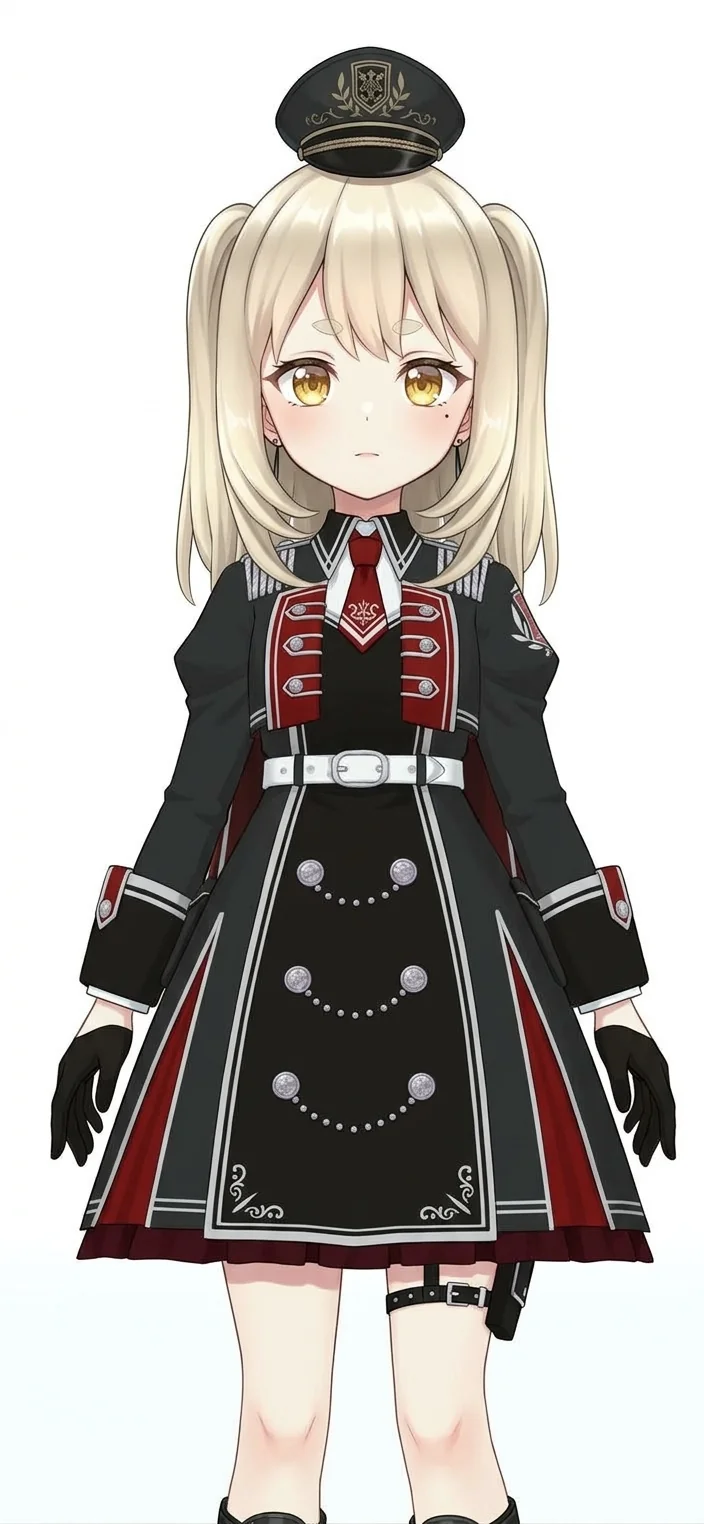
最初よりはマシですがホクロの位置は増えたり変わったり。ライフルも消えてます。ライフルは Gemini 的には「特徴」に含まれていないんですかね…。参考画像に忠実だという点では悪いとは言えませんが、コレジャナイ感が拭えません。
Grok
Grok にも ChatGPT と同じ指示をします。この時点で既に画像生成の上限に達しており、翌日試してもまだダメだったので X の方の Grok で試しました。体感ですが、ChatGPT よりも上限がくるのが早いです。
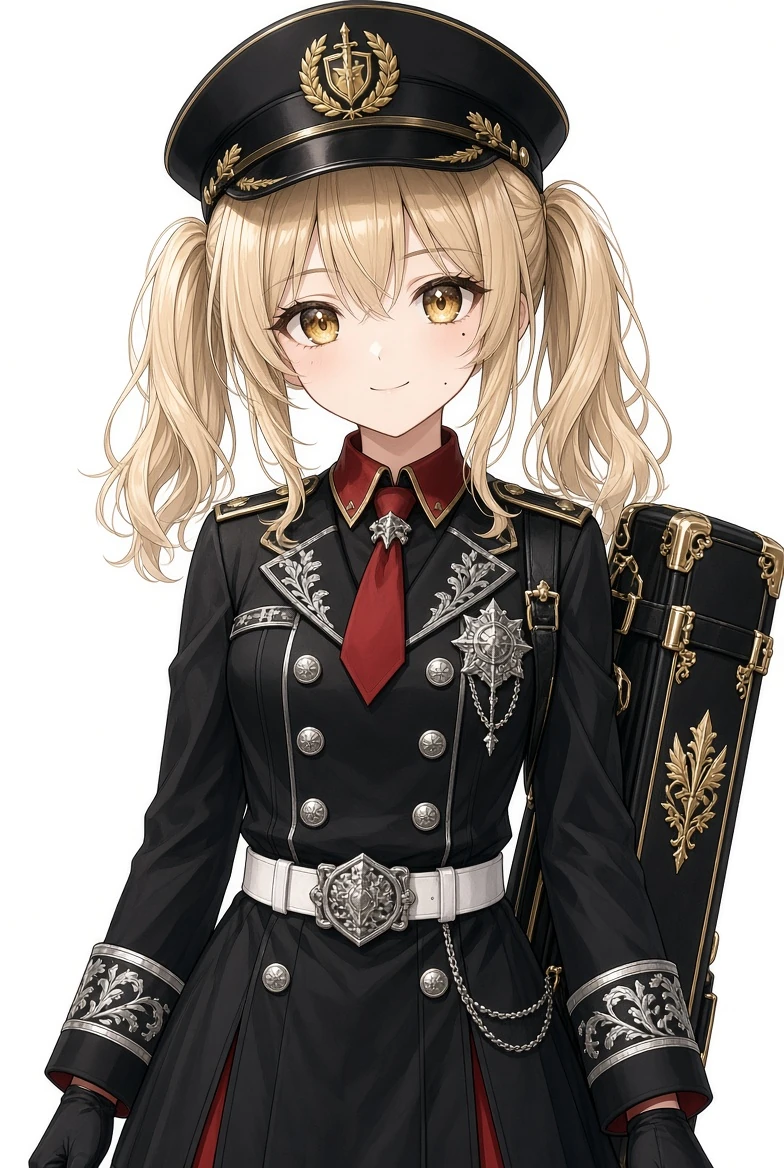
全身の画像を渡しても腰から上という指示は守れていますね。参考画像があっても変わらずハーフツインにはなっていませんし、ホクロの位置と数も服装も変わってしまっていますが、装飾の描き込みが細かくてリッチな感じに仕上がってます。拡大してよく見てみると破綻している箇所もありますが、金属の装飾や刺繍の細かさでいくとダントツで綺麗だと思います。これはこれで悪くないんじゃないでしょうか。
PixAI
日本語プロンプトが有効だと分かったのでポジティブプロンプトには日本語を入れます。モデルは Haruka v2 のままです。LoRA は指定しません。
子ども、金髪、ツーサイドアップ、金色の目、麻呂眉、口元右にほくろ、黒の軍帽、黒の軍服ワンピース、赤いネクタイ、白いベルト、黒の手袋、背中にライフル、腰から上、正面、こちらを見ている、口を閉じた微笑み、腕を下ろしている、白背景
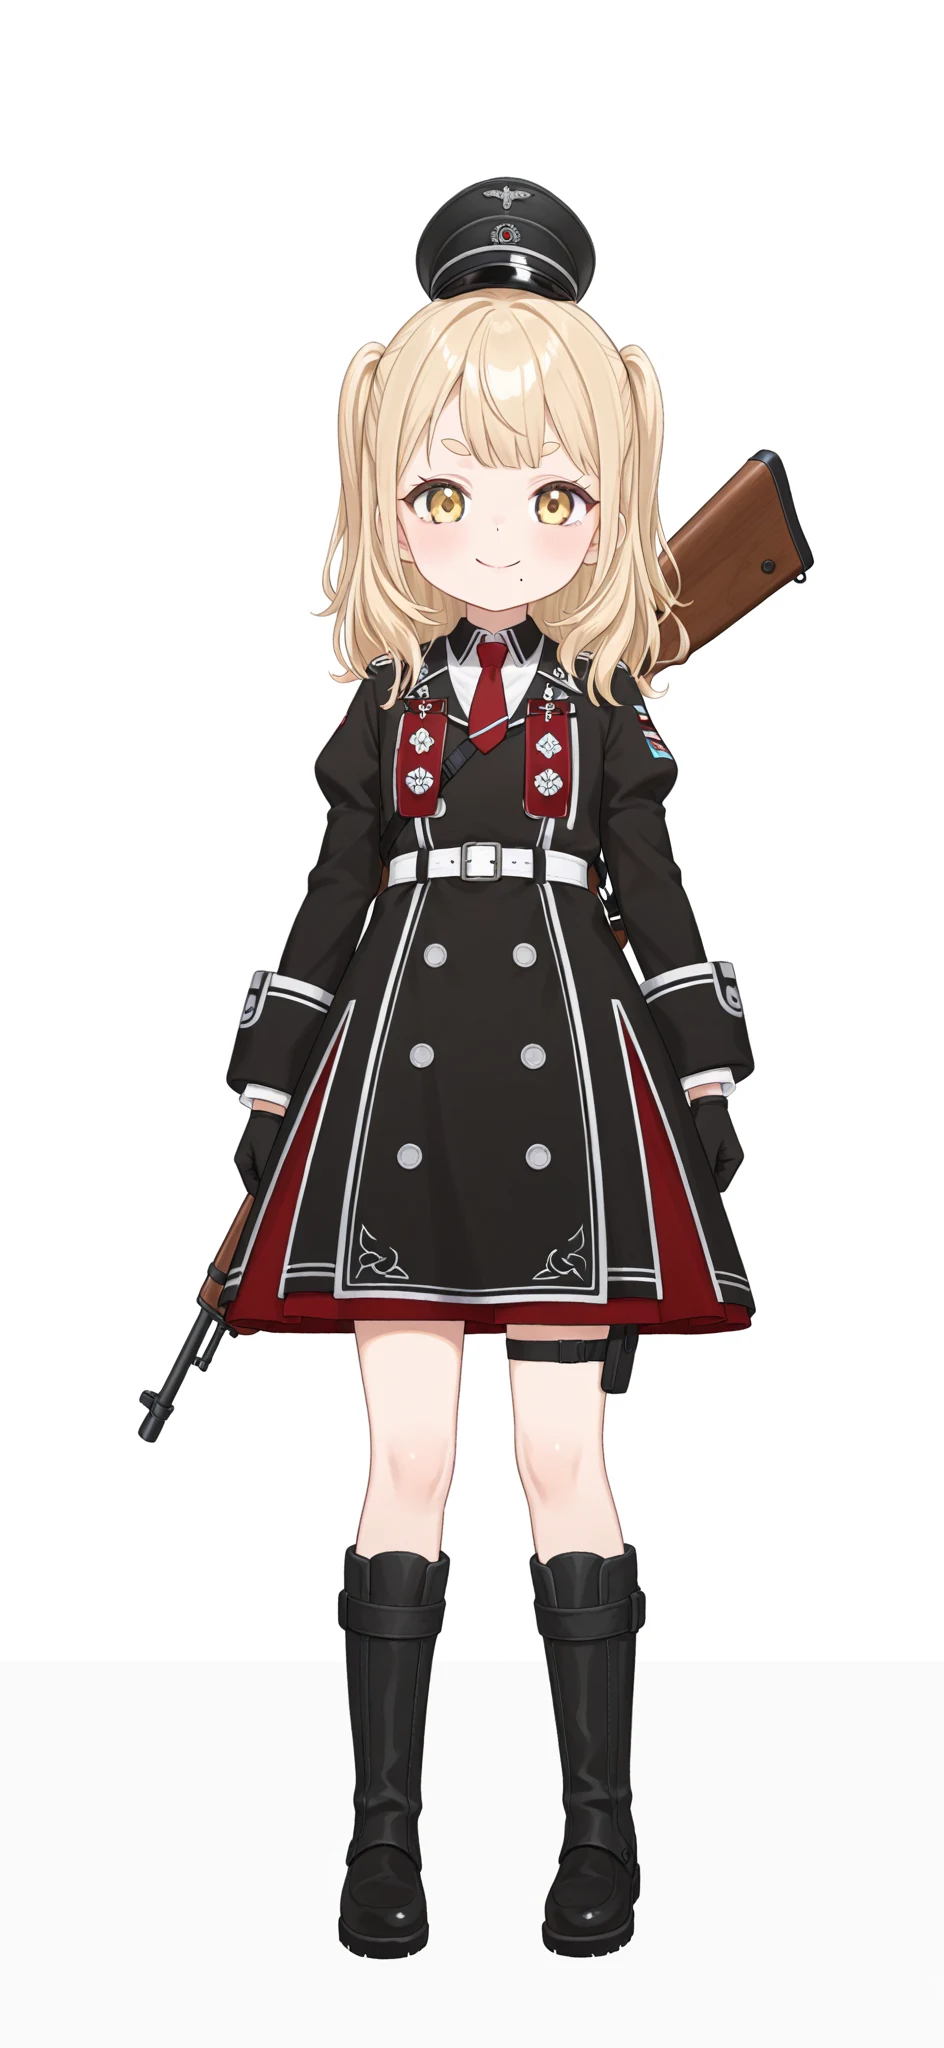
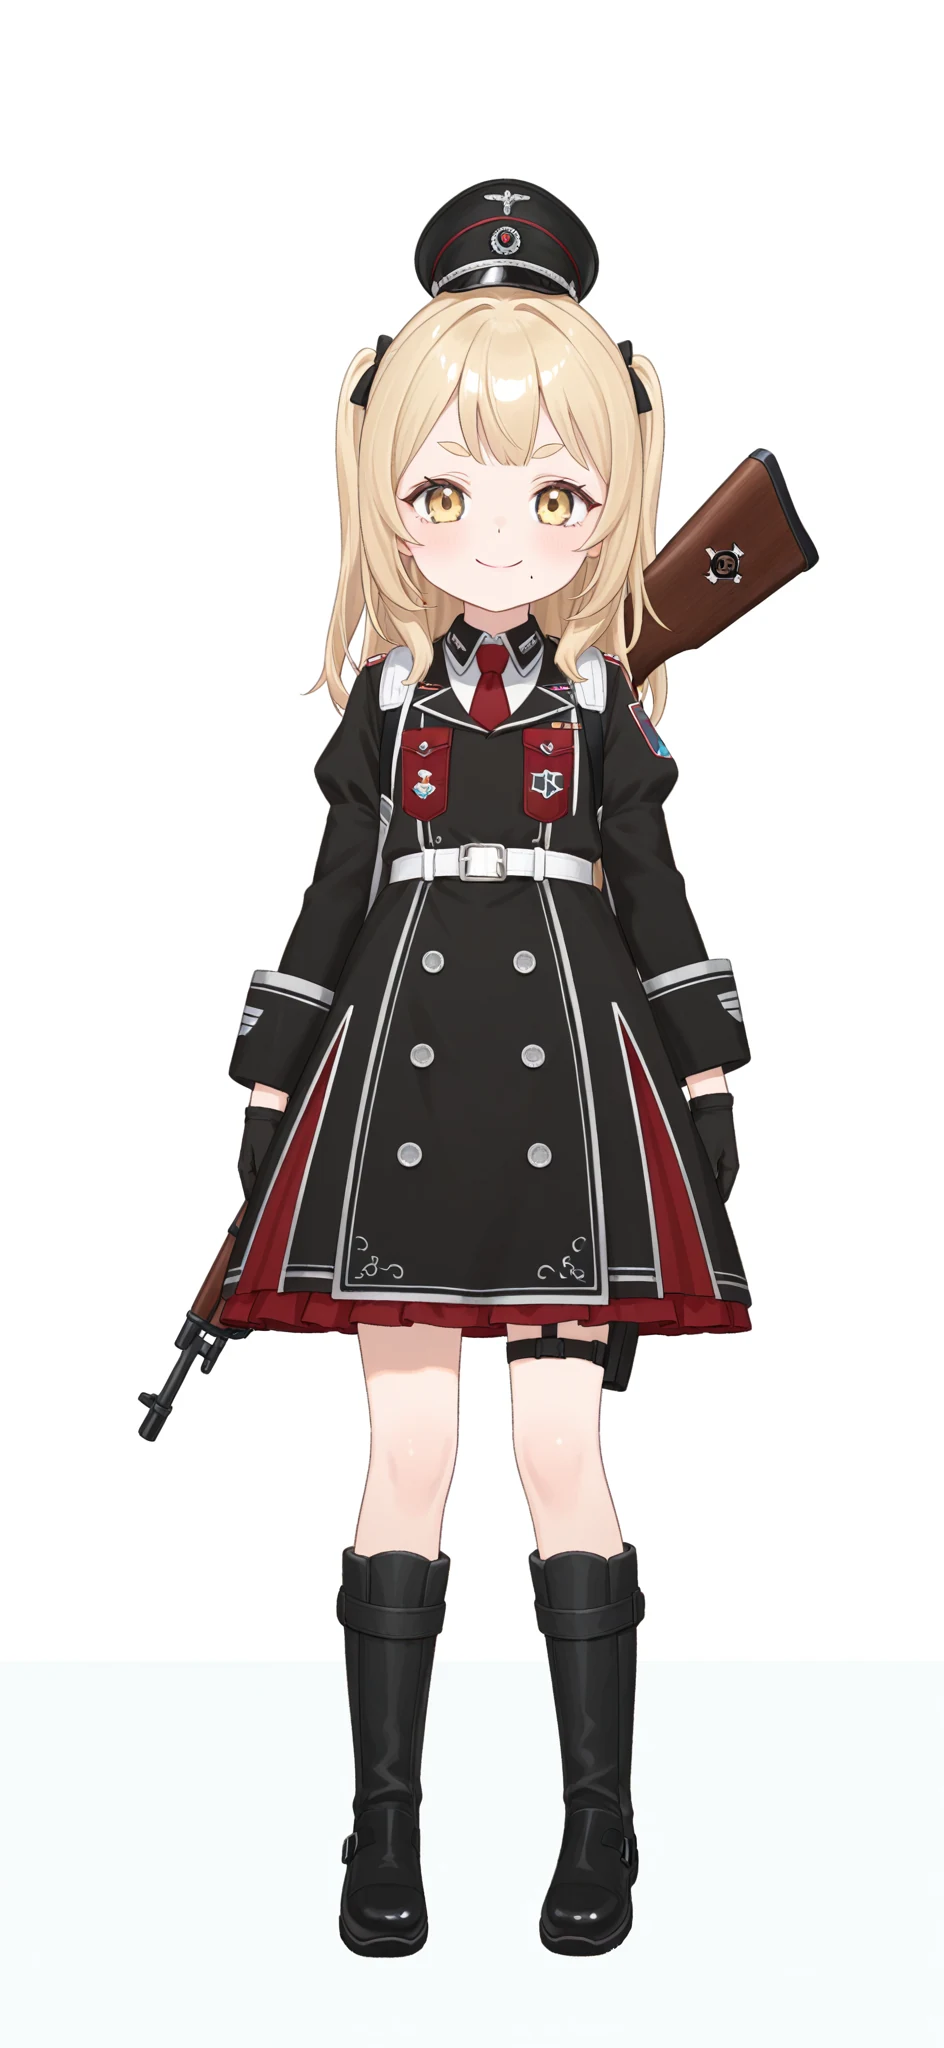
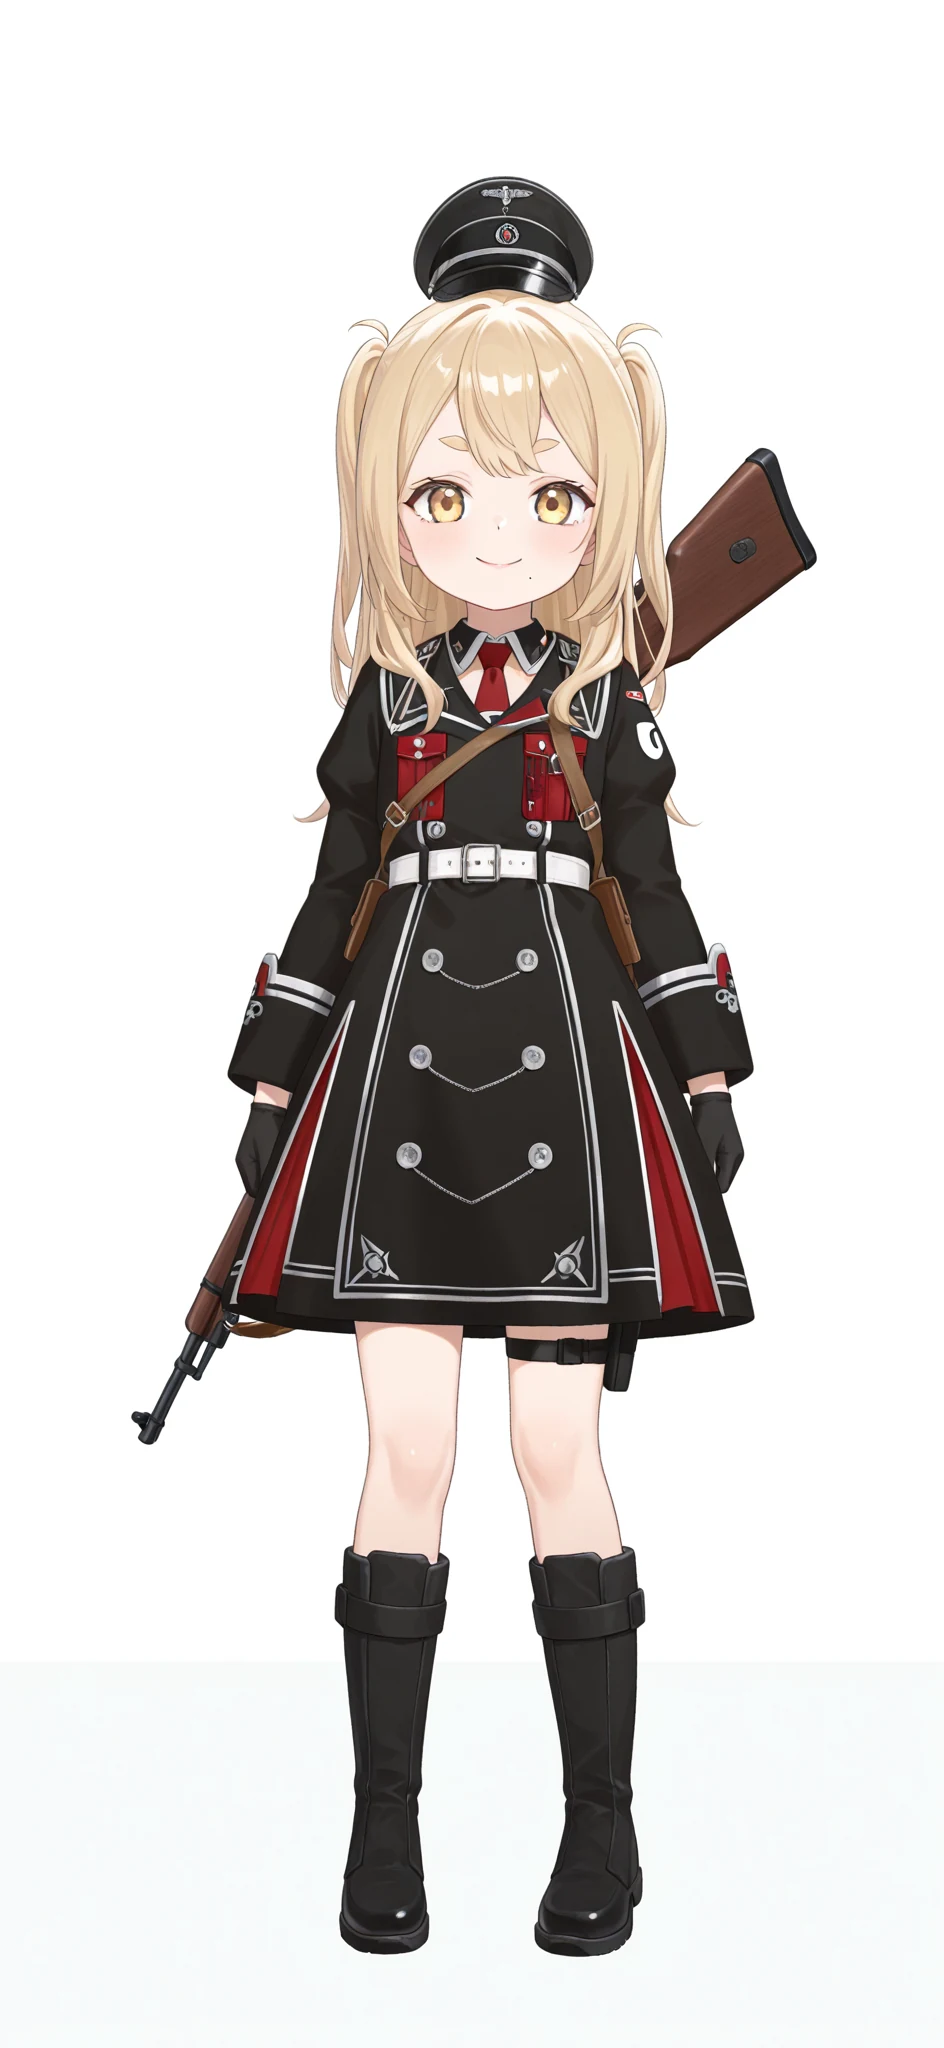
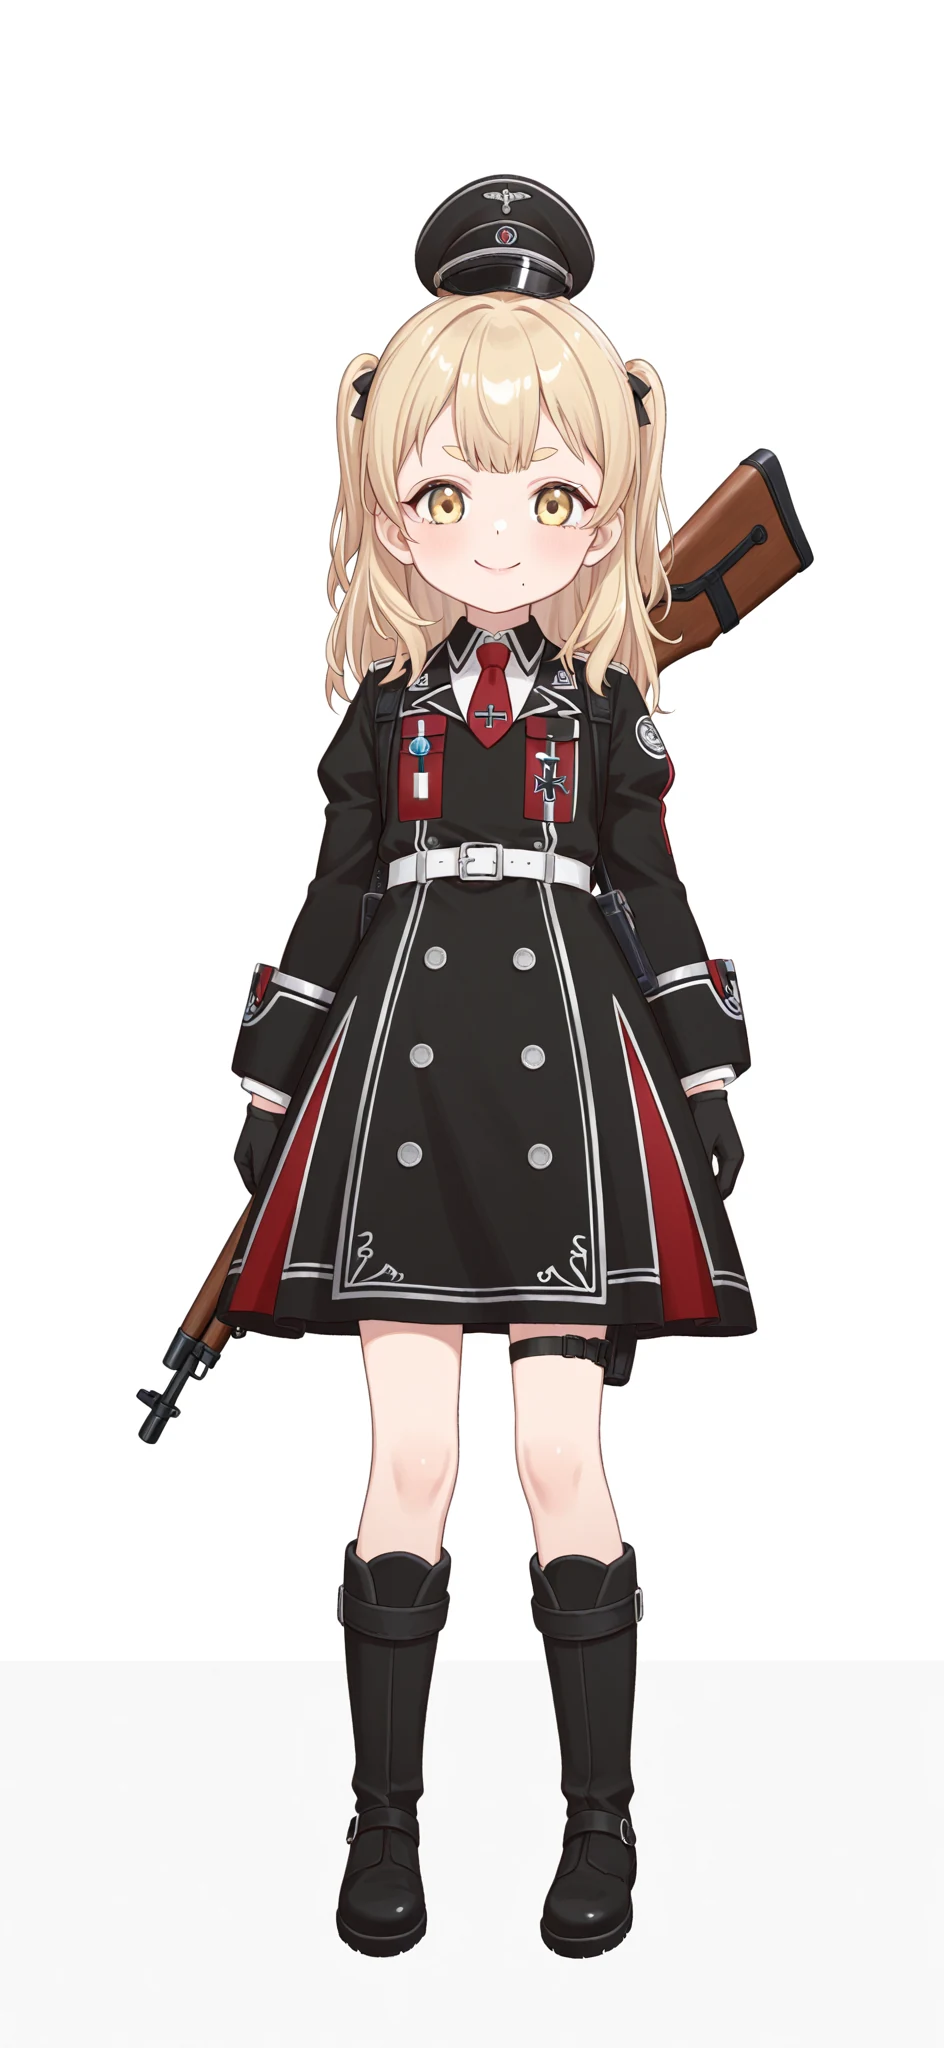
参考画像が全身なので、腰から上をプロンプトに入れても無視されます。スカートの高さでトリミングした状態で再度同じプロンプトで出力します。
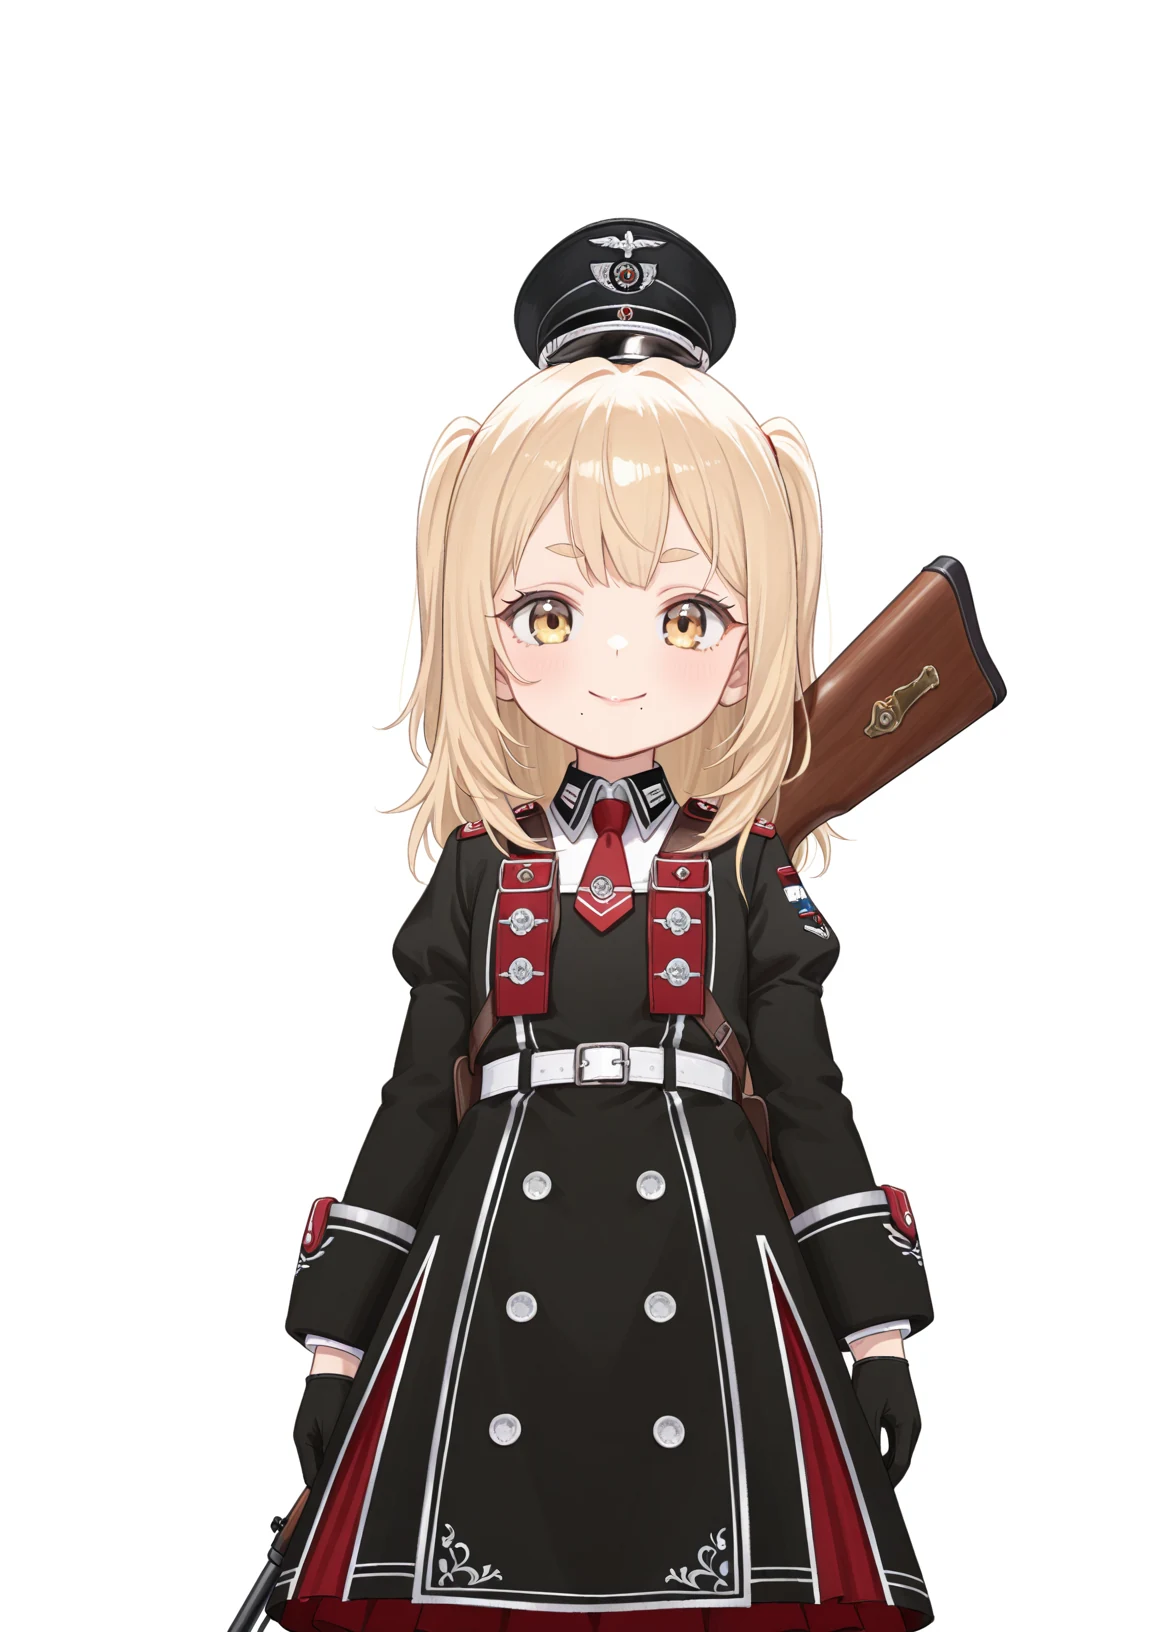
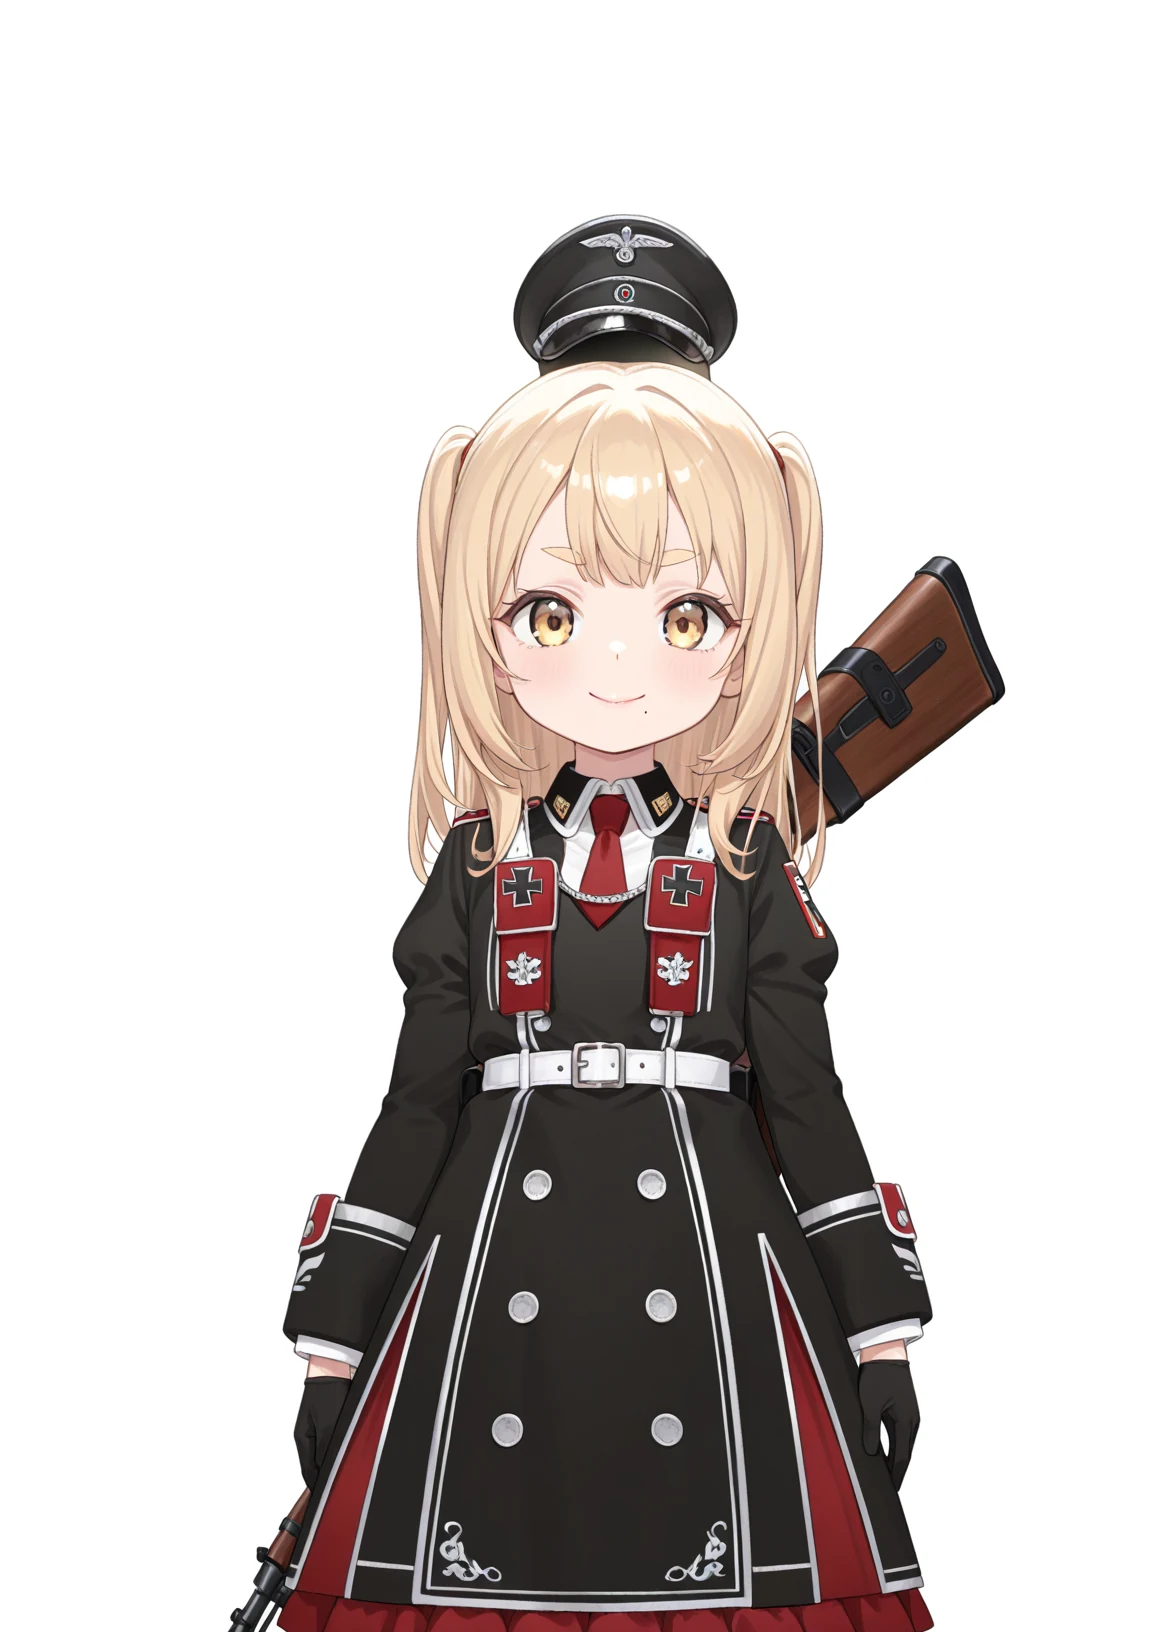
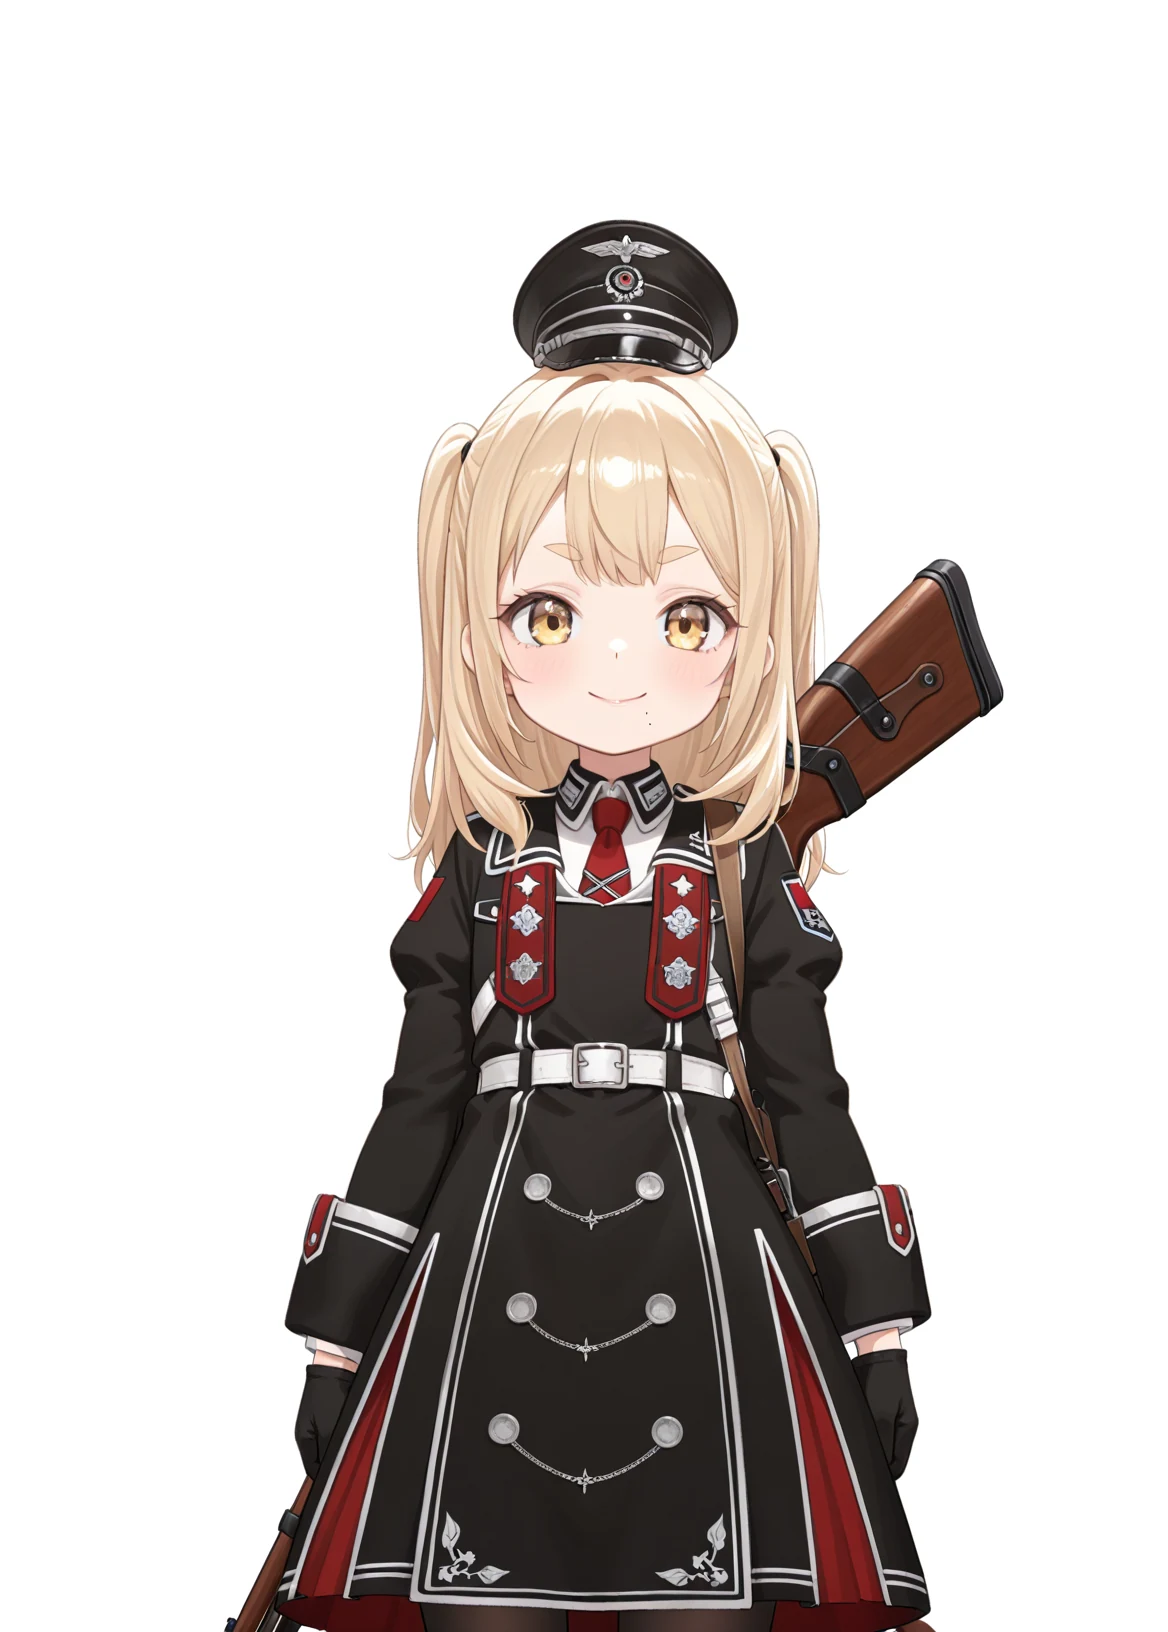
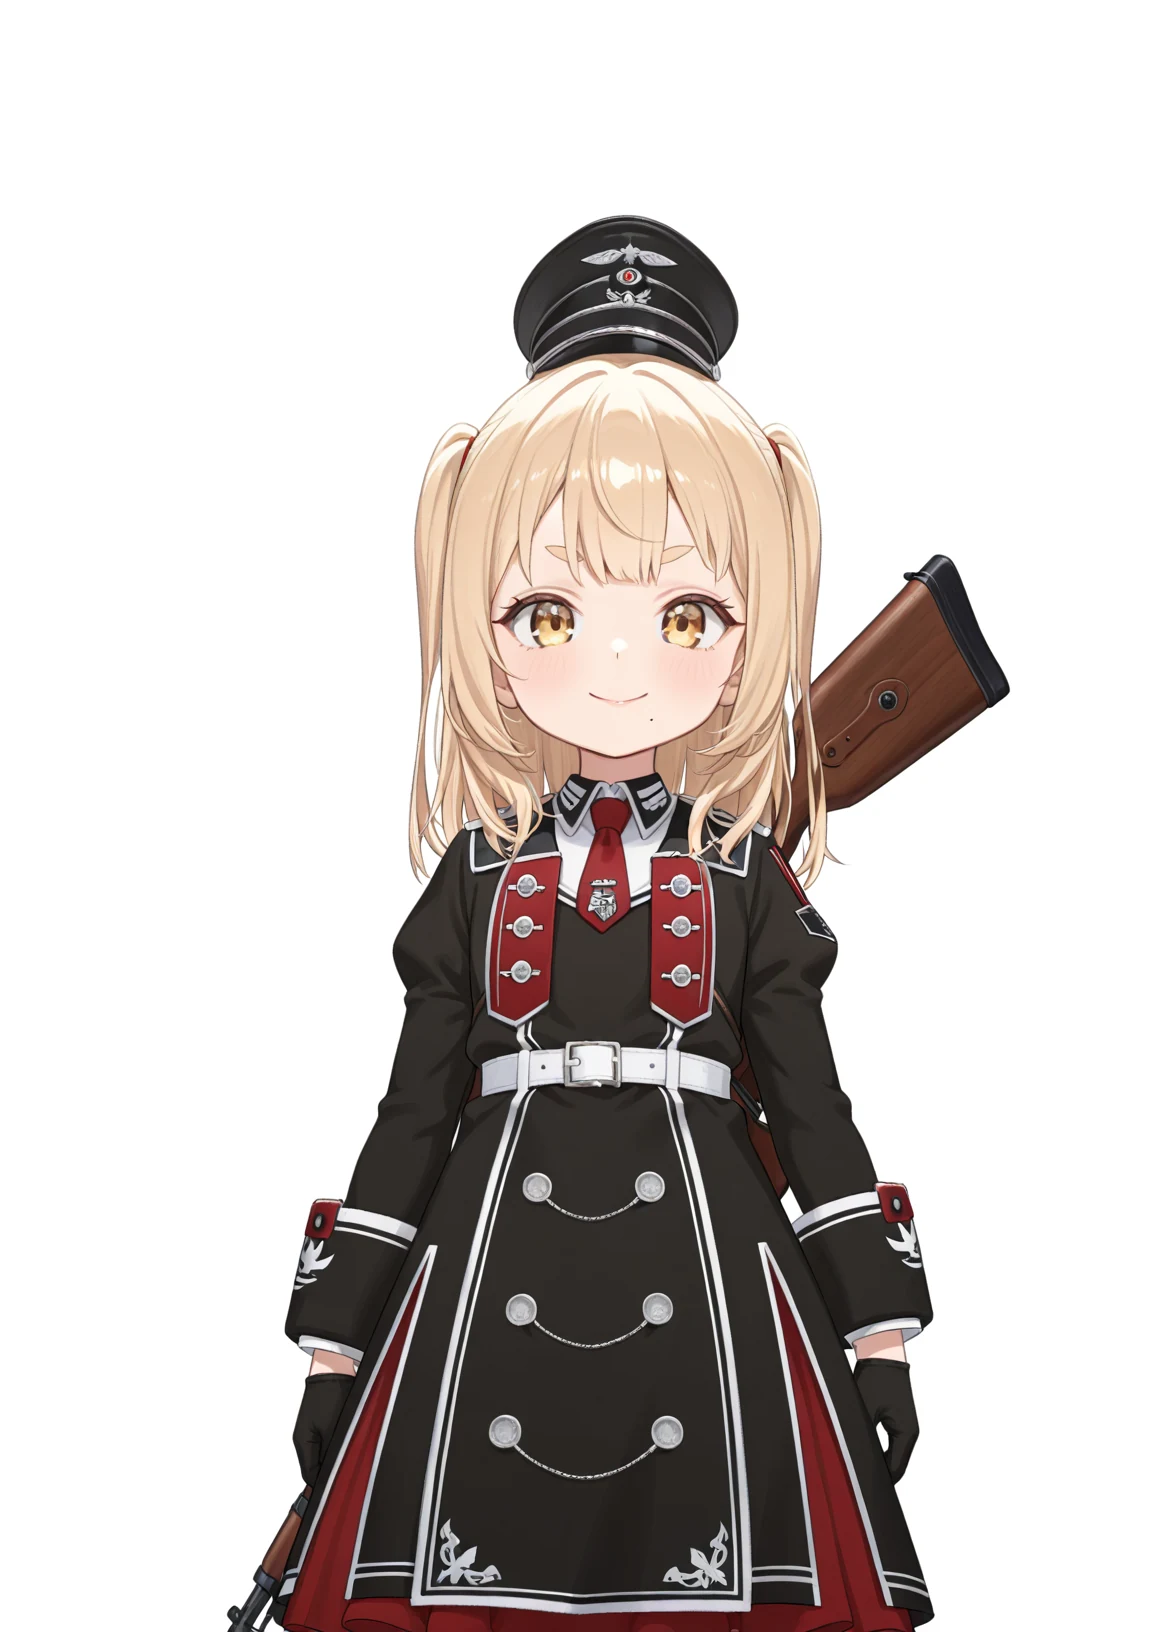
軍帽に鷲の徽章が描かれ、2枚目は胸に鉄十字まで入っています。全身で出力した4枚目にも鉄十字がありました。ナチスドイツの軍服を連想させるデザインは配信で使うと問題になりかねないので、ネガティブプロンプトを追加します。日本語のネガティブプロンプトは効いてないようだったので、英語に書き換えます。
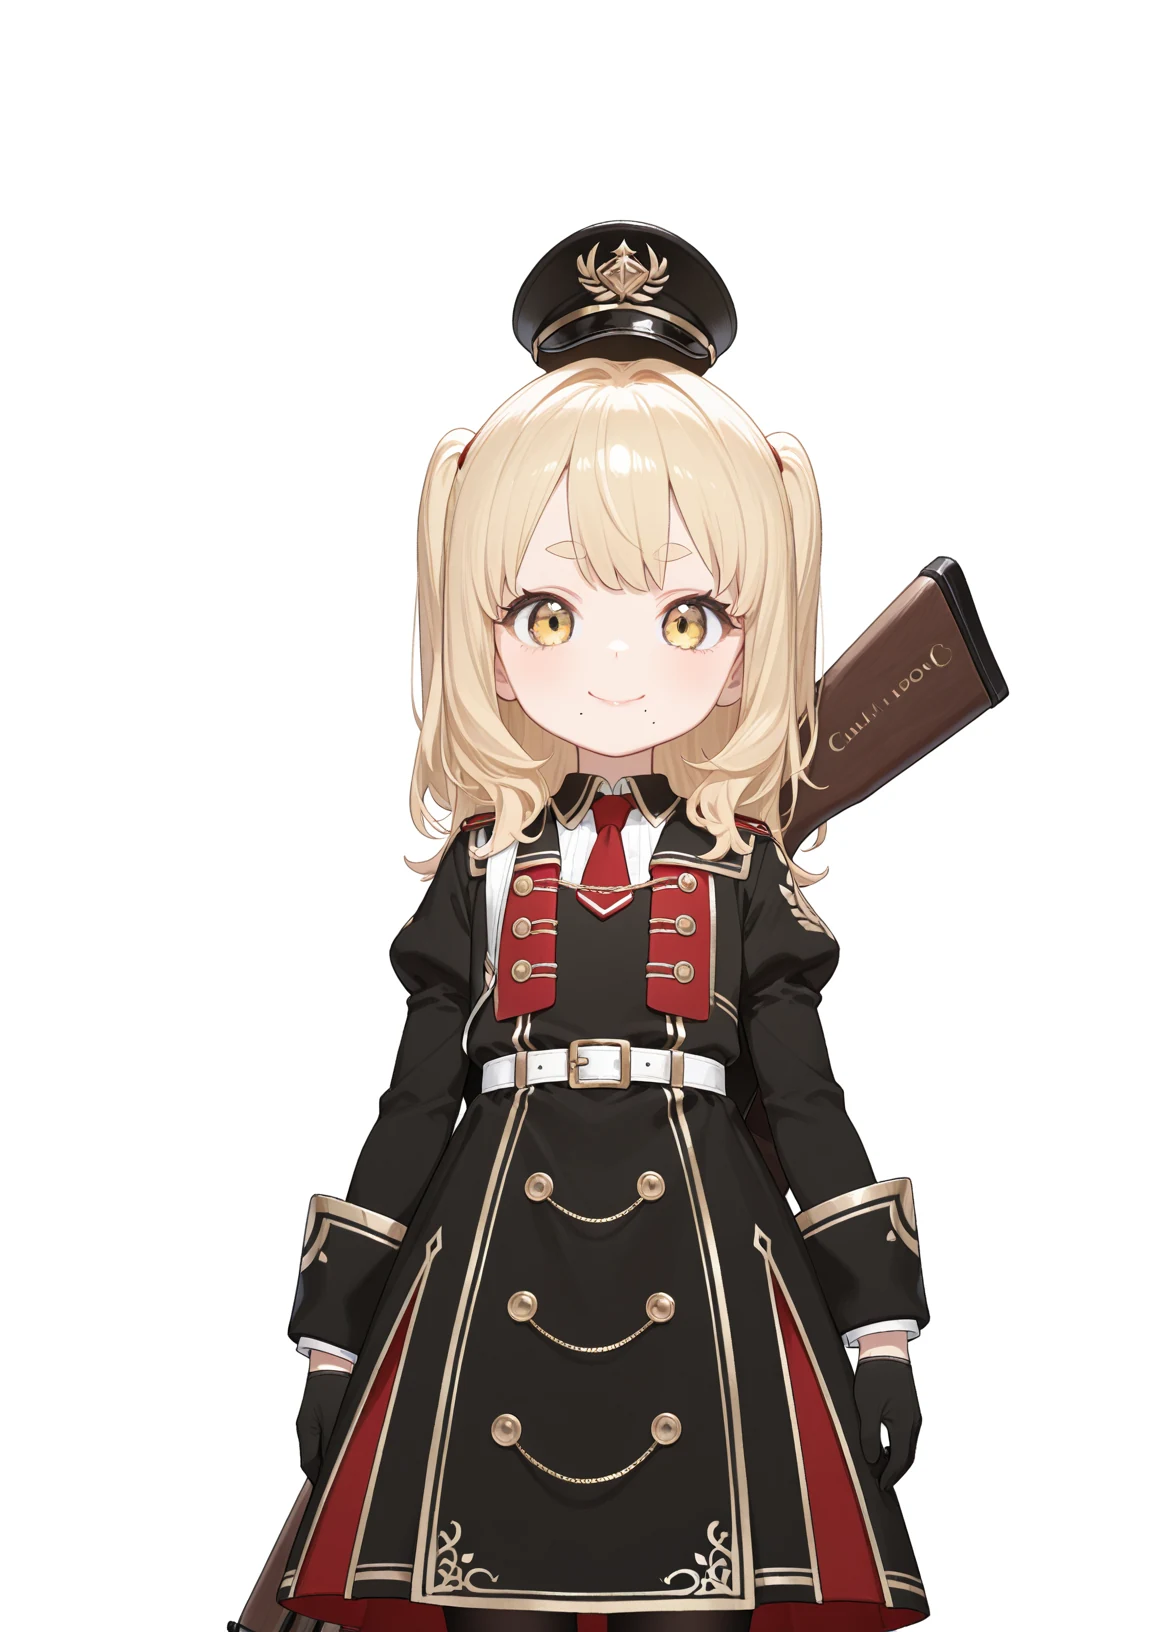
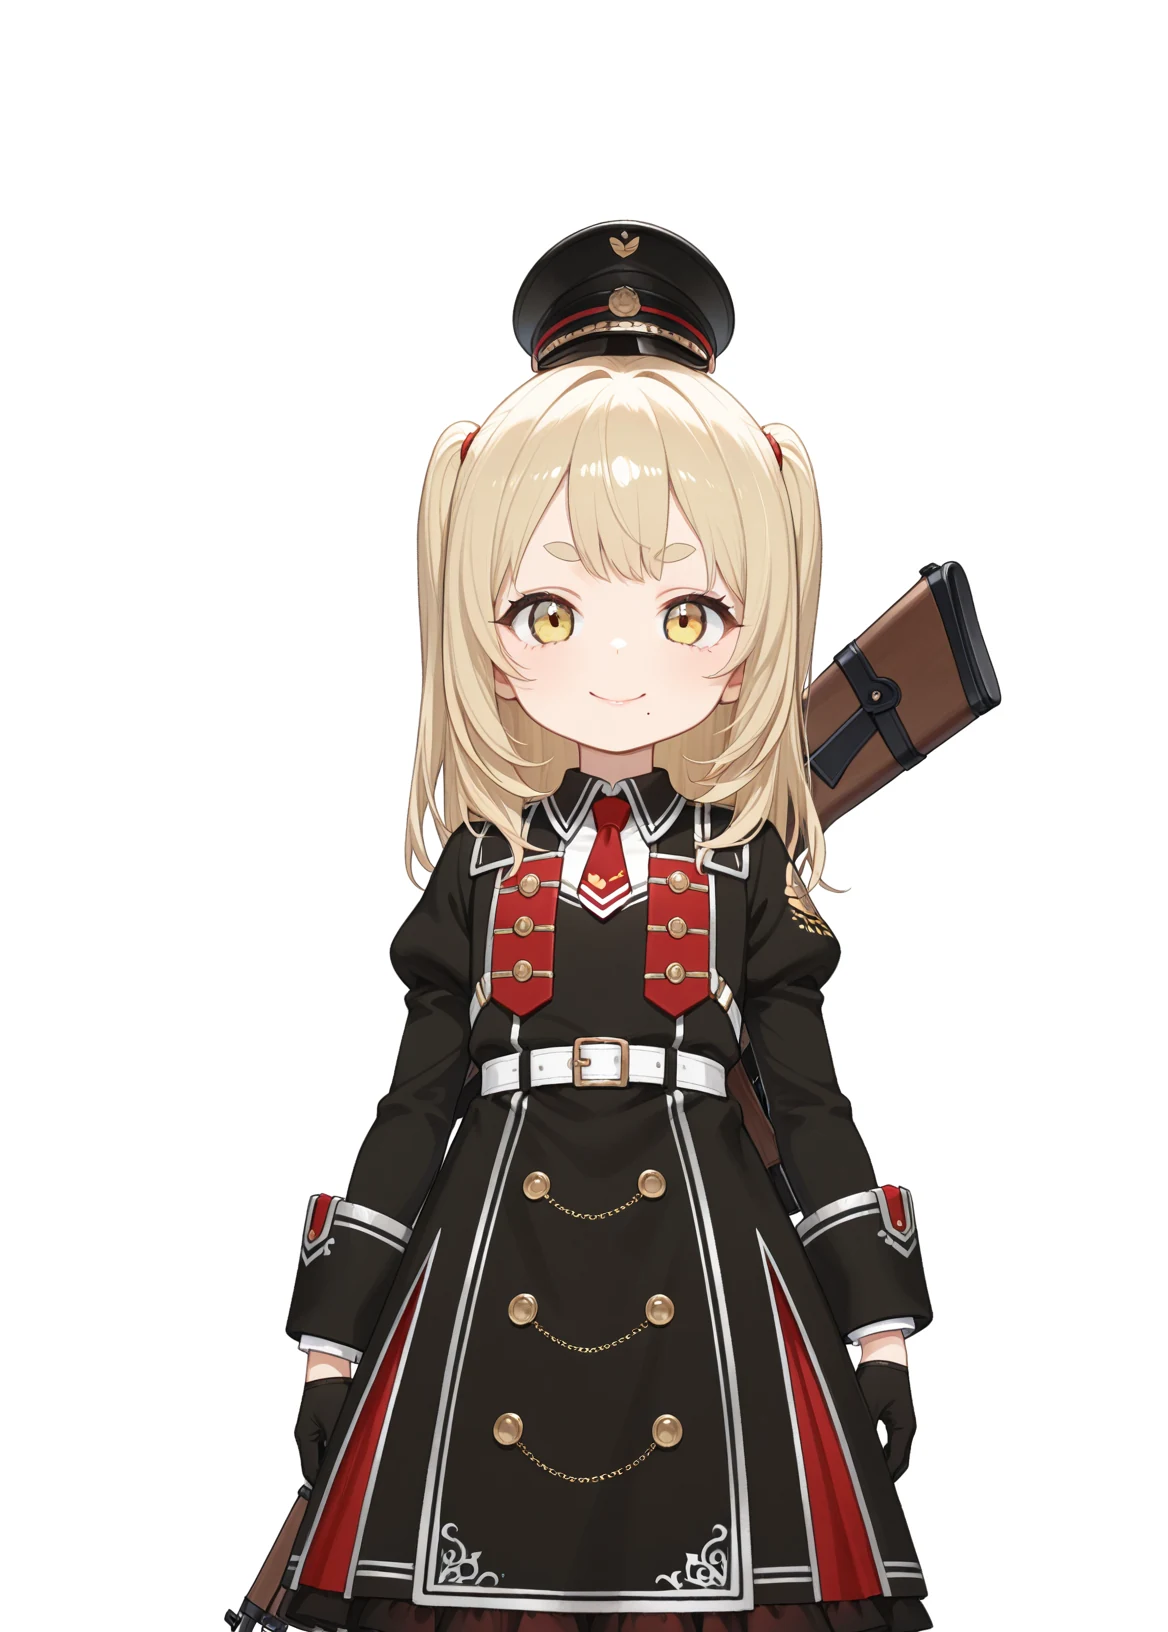
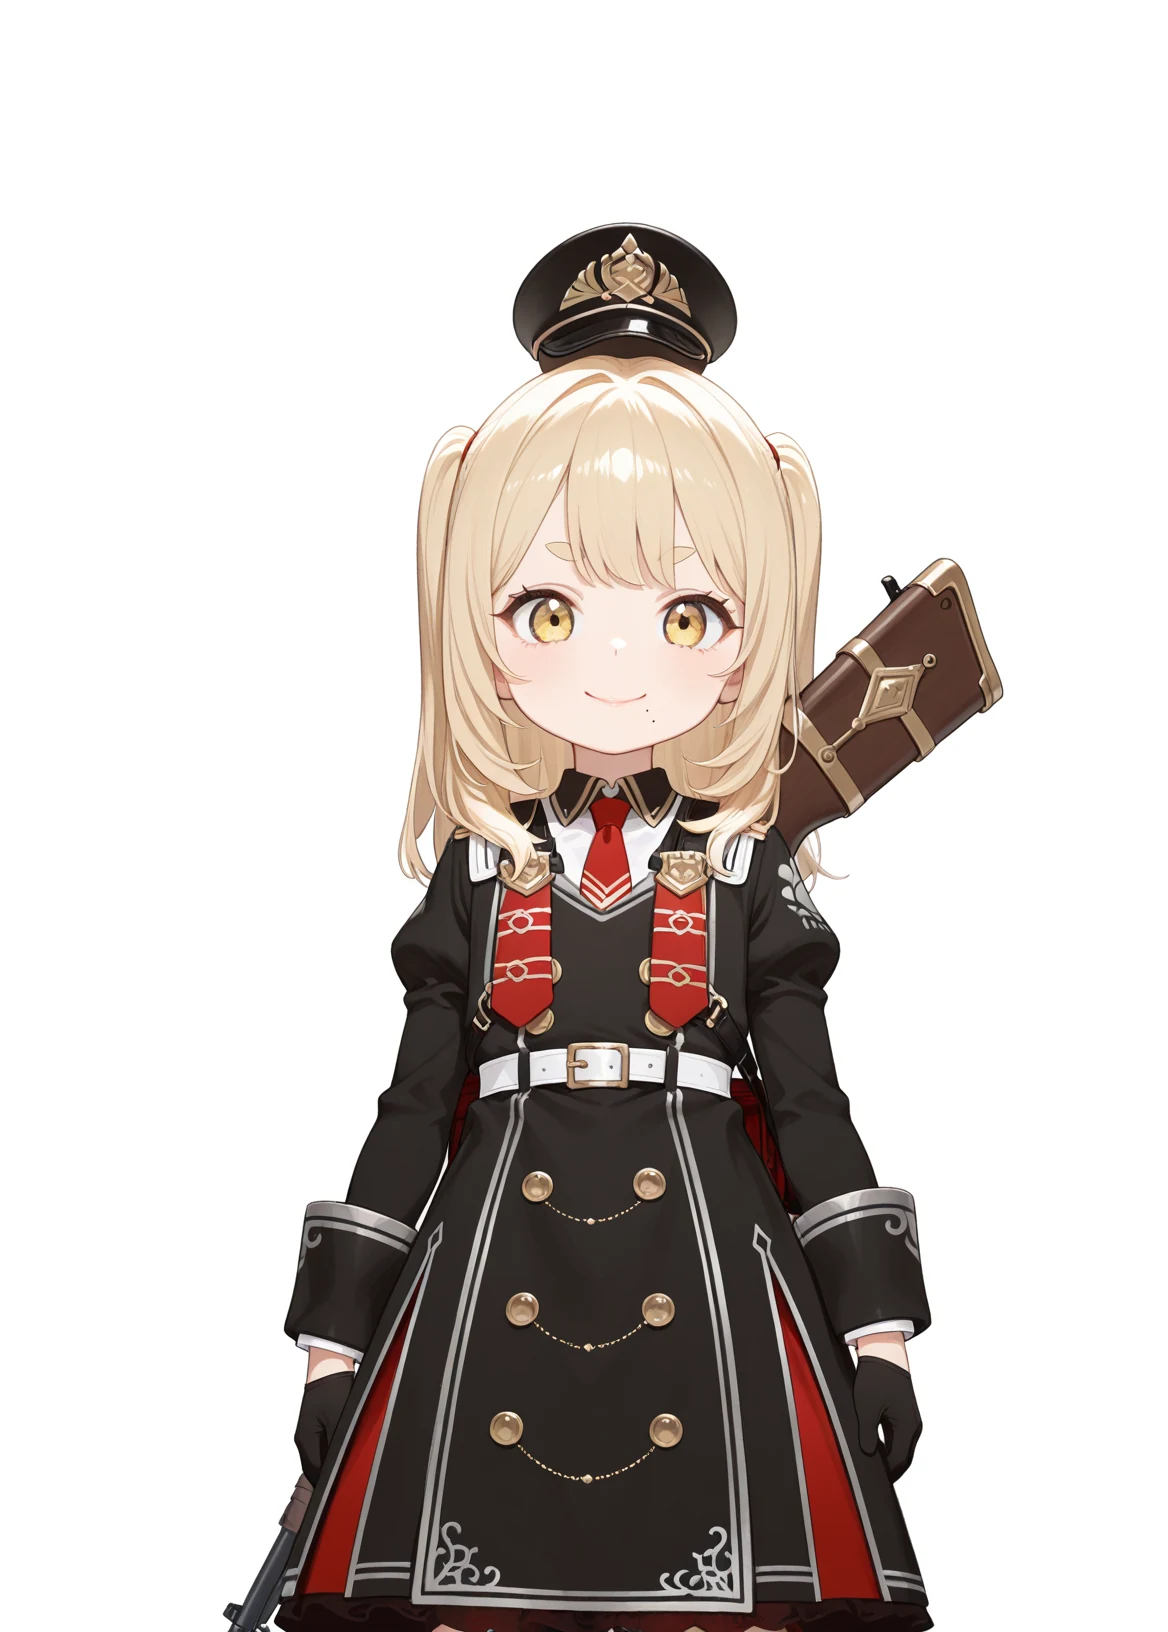
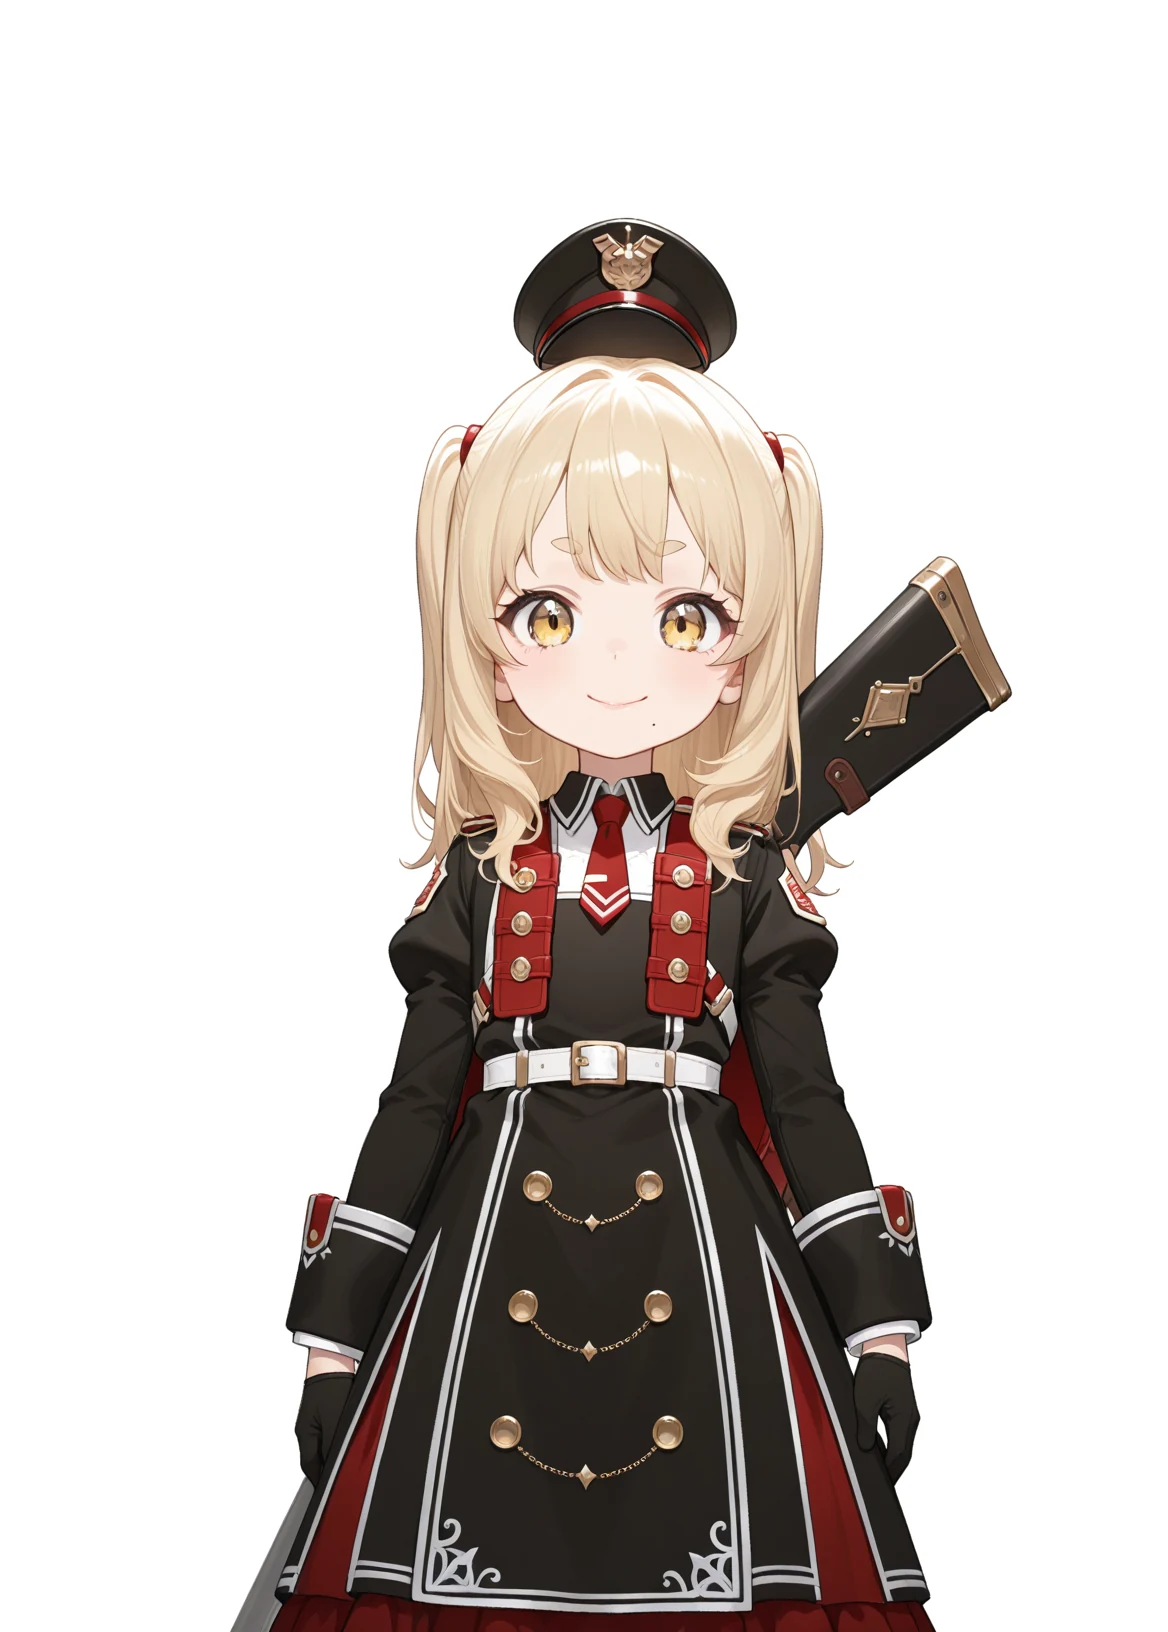
ホクロは安定しませんが概ね参考画像を可愛くした絵が出力されました。軍帽はみんな宙に浮いて見えますが。細部の書き込みが雑な気がするので、描画クオリティ関連のネガティブプロンプトを足したり LoRA を追加したりすればもっと良くなりそうです。
ComfyUI
先程と同じくモデルは WAI-illustrious-SDXL v16 です。画像を渡すためにワークフローを変更する必要がありますが、その辺の話は趣旨から外れるので飛ばします。渡す画像も先程の PixAI に使ったトリミング画像の方にします。
ノイズ除去のパラメーターを 0.5 から 0.8 まで順に上げて出力してみました。ノイズ除去の値が低いほど参考画像に近くなります。
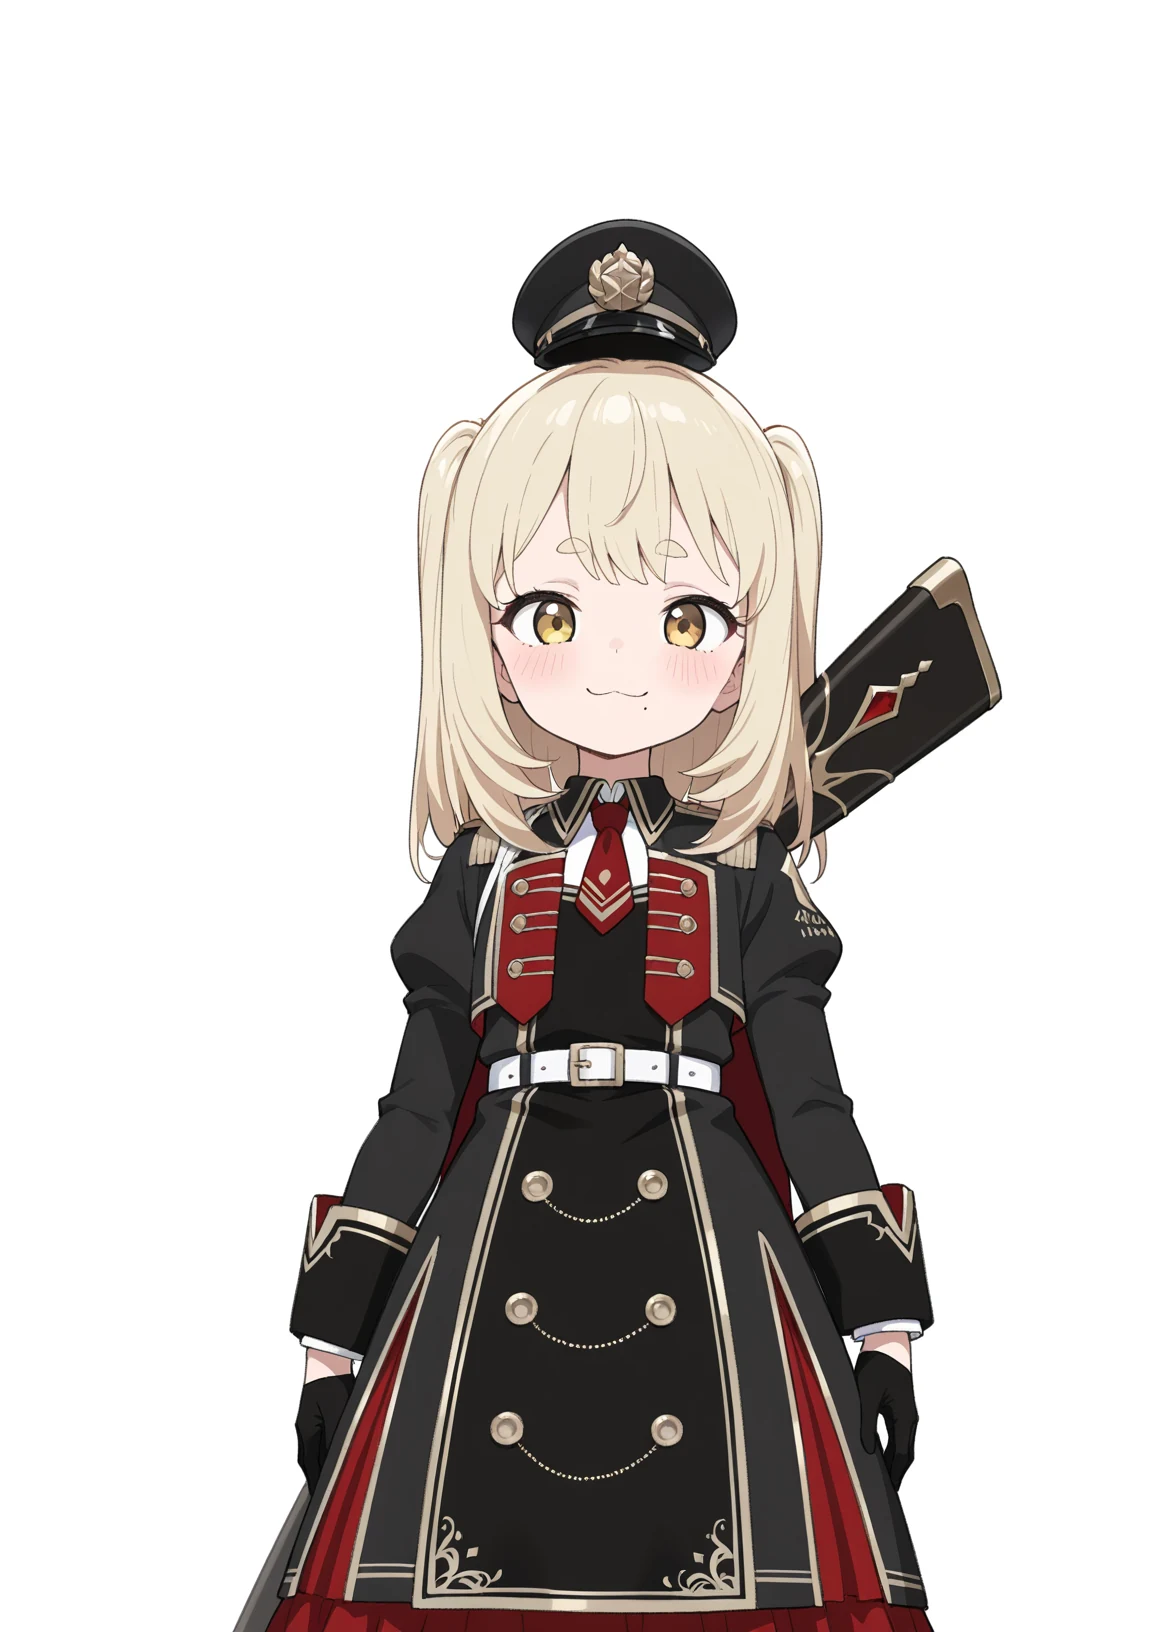
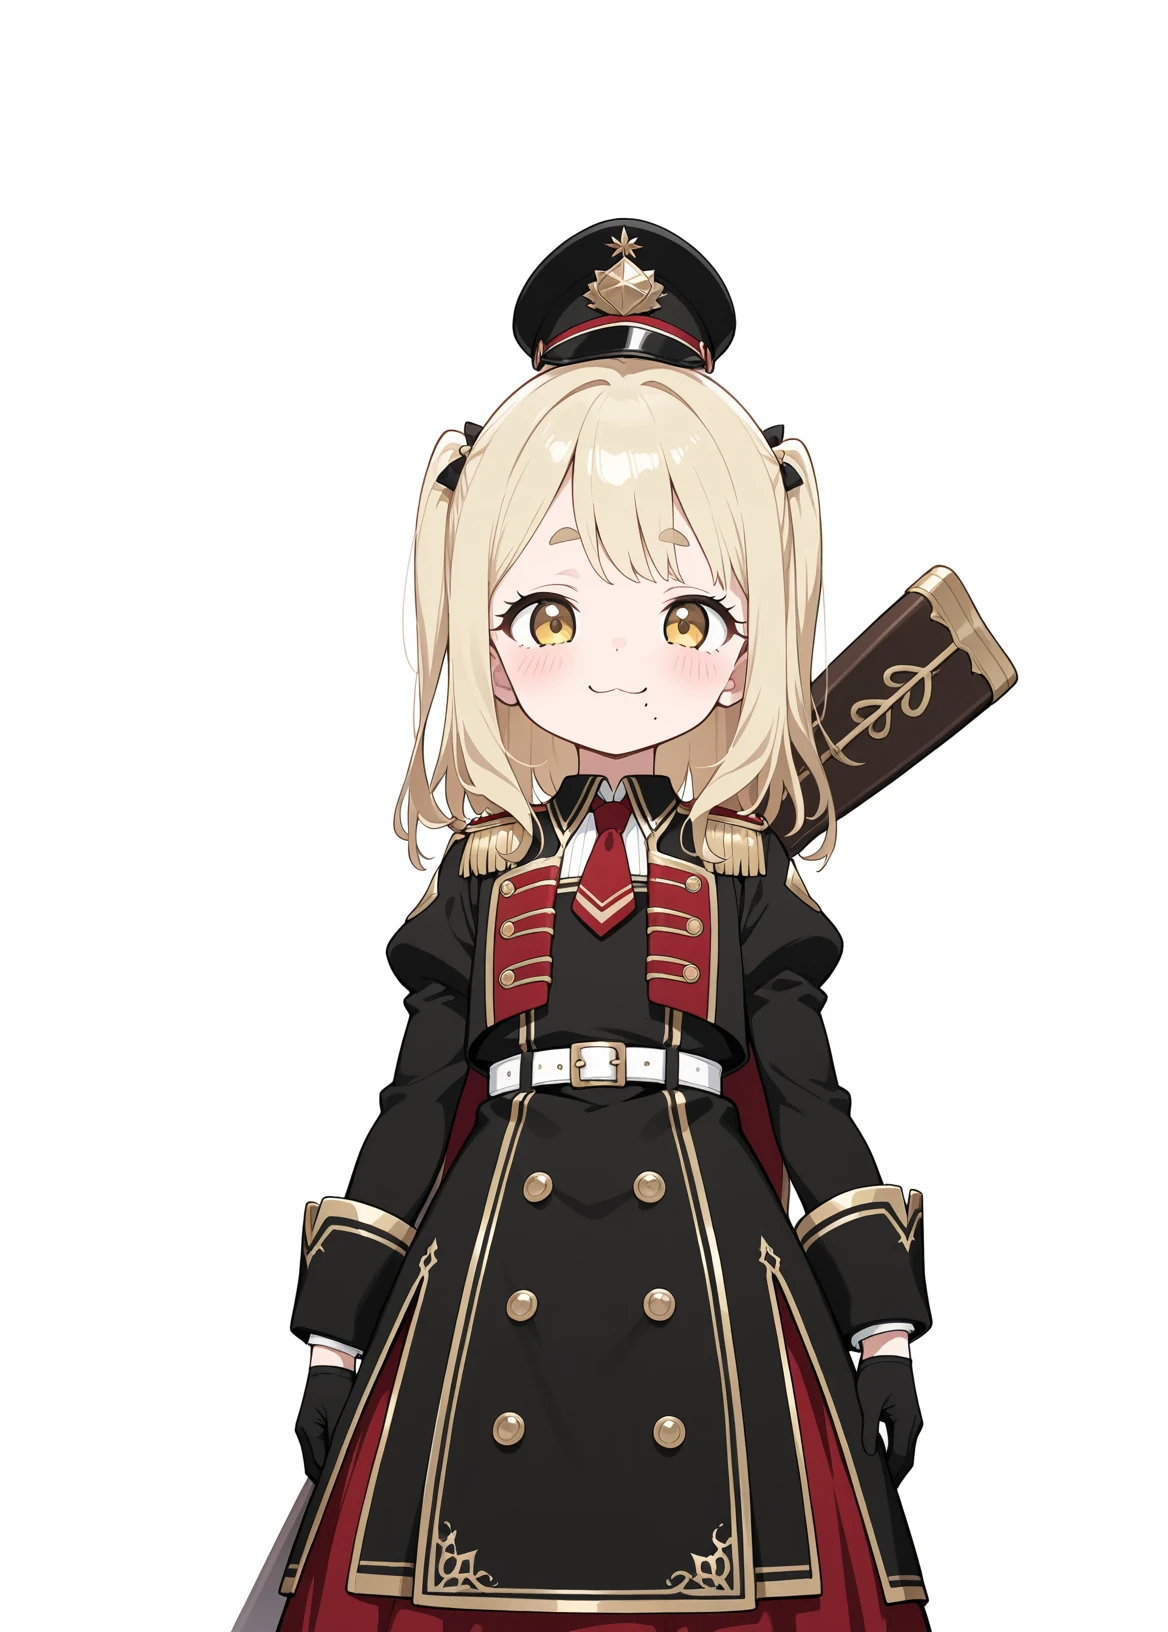
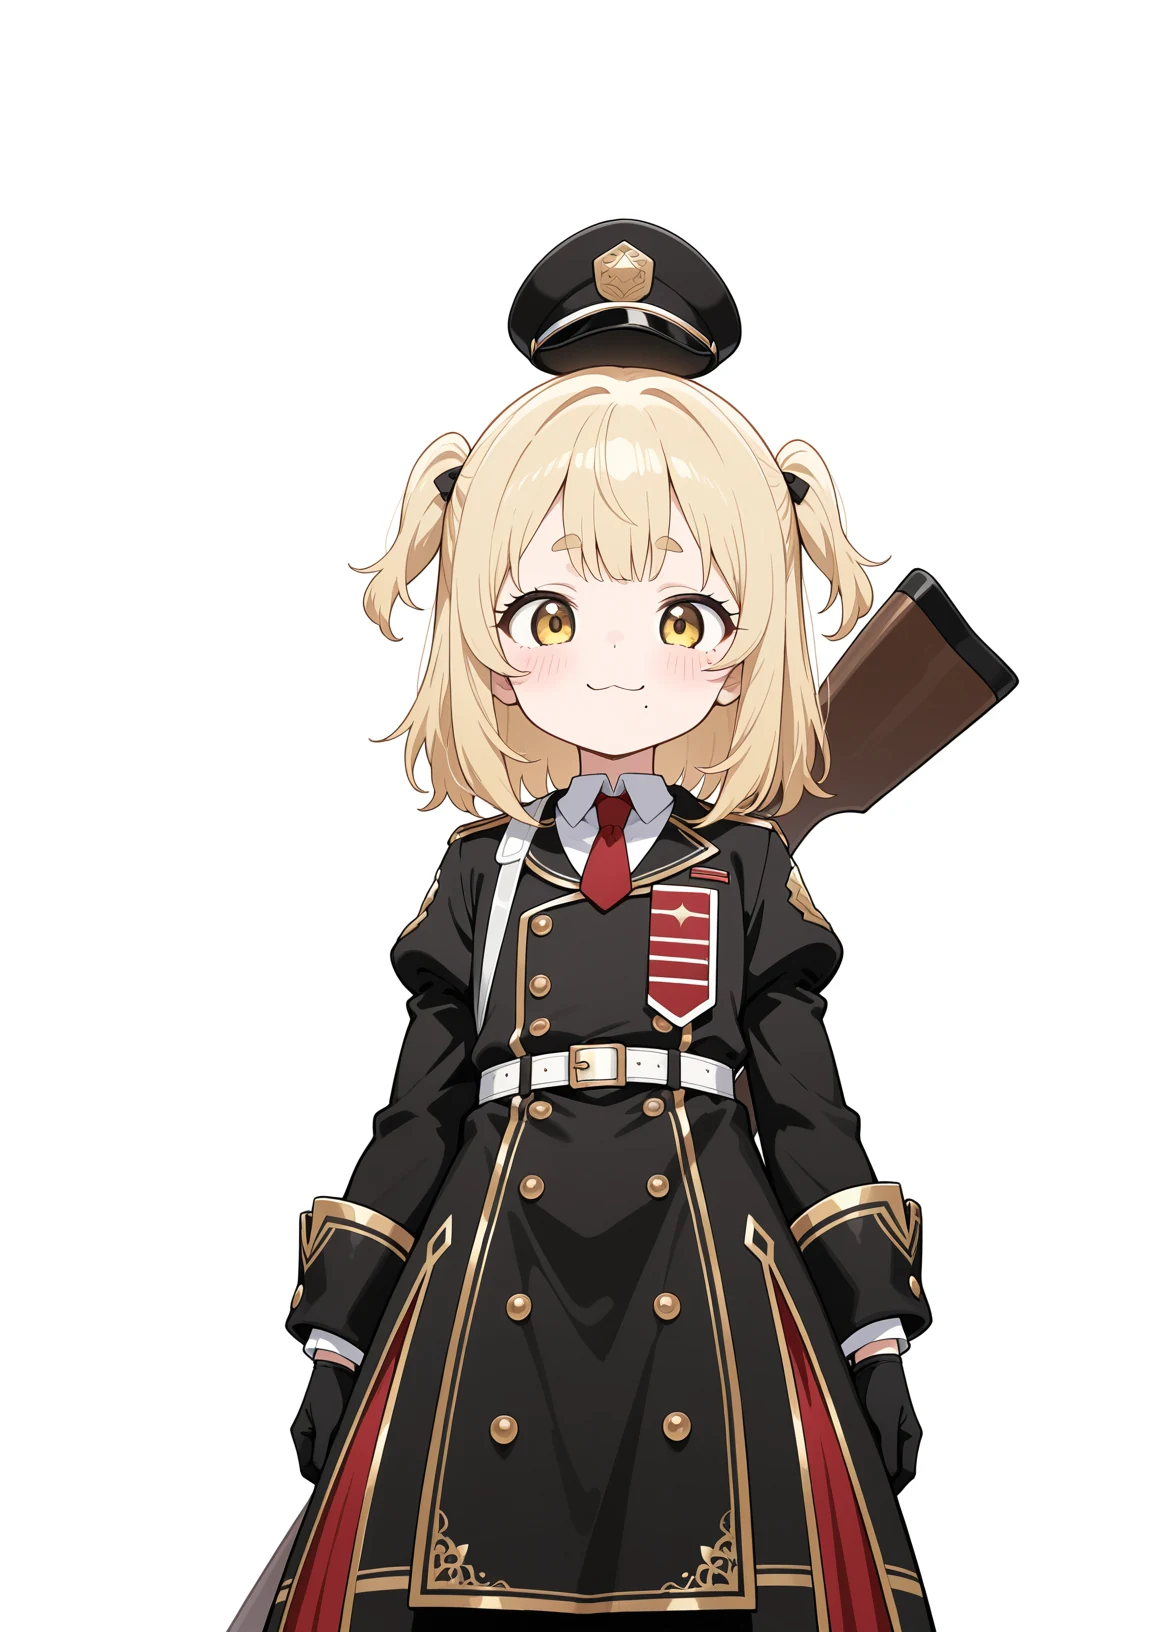
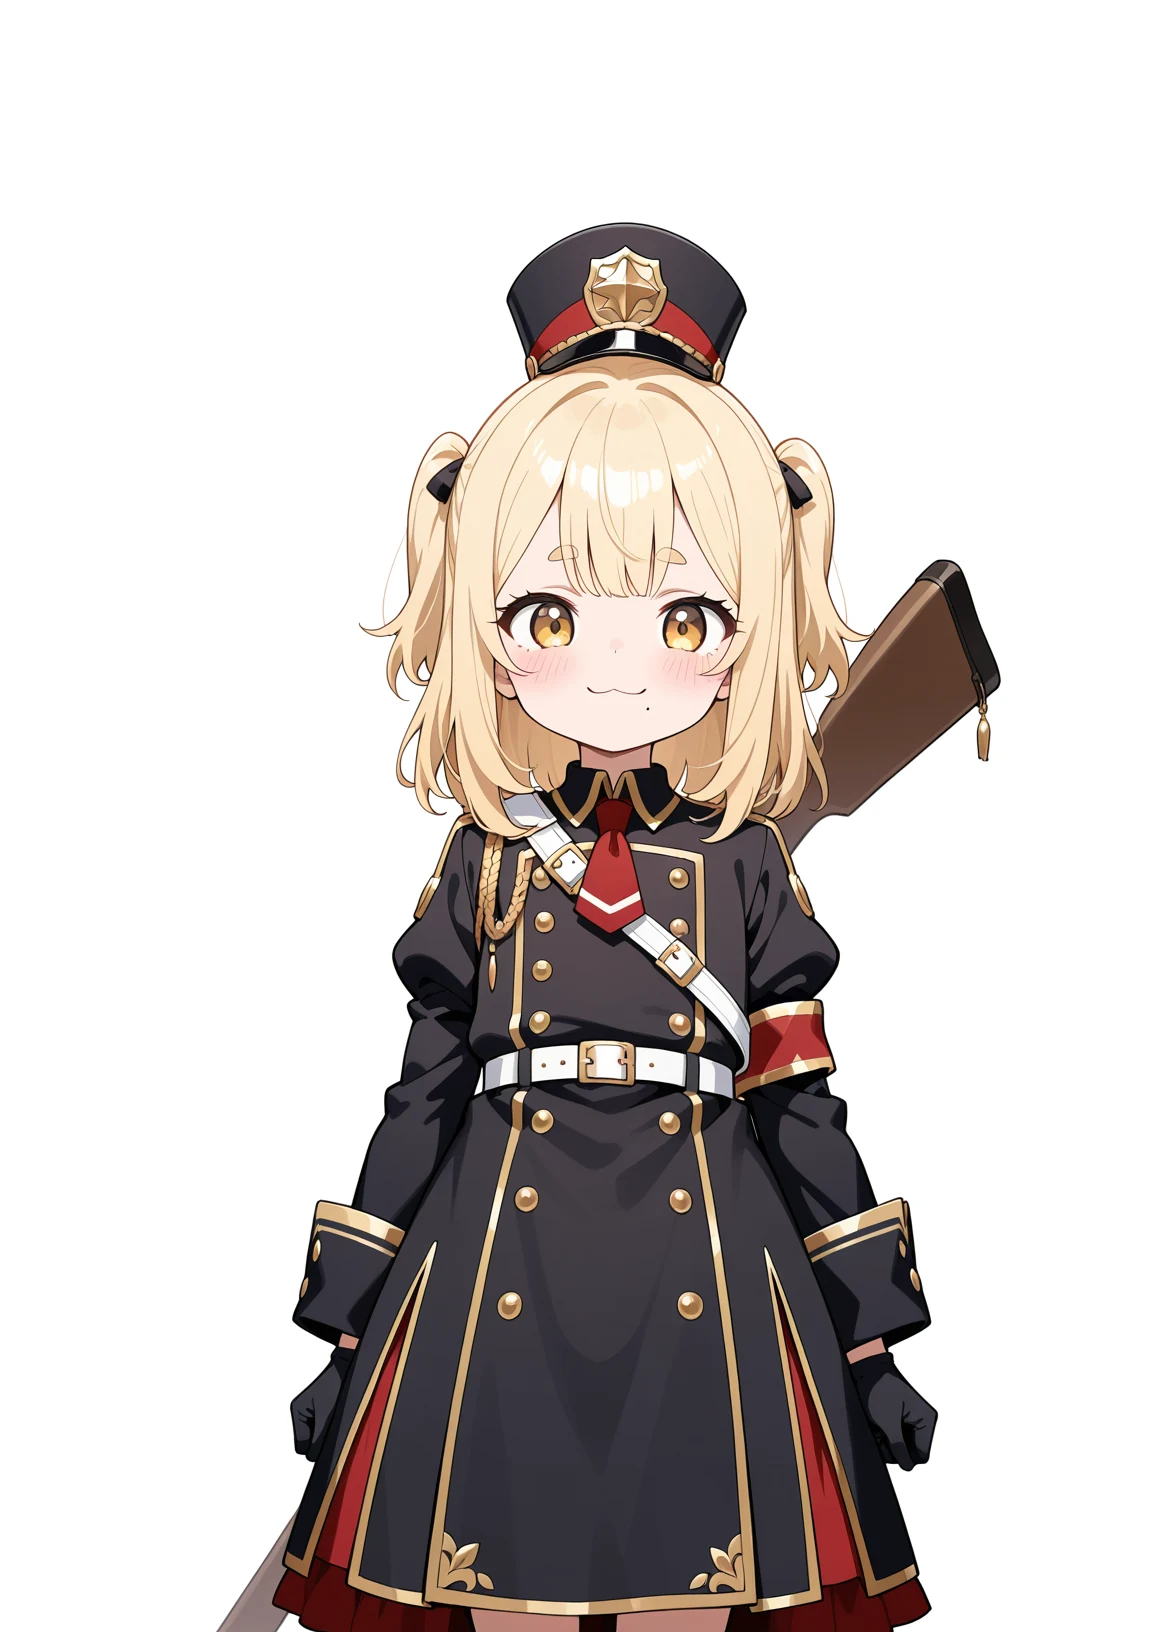
軍帽が若干浮き気味ですが、可愛いですね。ノイズ除去 0.5 は髪の毛と銃の重なり方も参考画像の通りです。
画像から再生成のまとめ
| AI | よかったところ | 気になったところ |
|---|---|---|
| ChatGPT | 背景を透過した状態で、いい感じに出力してくれた | 背景は白と指示したのに透過で出力された |
| Gemini | 参考画像に忠実 | 同じ指示では髪を伸ばしてライフルを消した以外ほぼ 3D のまま。2D に描き直す指示にしてもホクロの位置は安定せず、ライフルも消える |
| Grok | 全身の画像を渡しても腰から上の指示が守れた。金属の装飾や刺繍の描き込みが細かい | 体感では ChatGPT よりも画像生成の上限がくるのが早い。ハーフツインにならない。ホクロの位置と数、服装が変わる |
| PixAI | 概ね参考画像を可愛くした絵が出力された | 参考画像が全身だと腰から上の指示が無視されるので、トリミングが必要。鷲の徽章や鉄十字が描かれ、日本語のネガティブプロンプトは効かなかった。ホクロが安定しない |
| ComfyUI | 可愛い。ノイズ除去 0.5 は髪の毛と銃の重なり方も参考画像の通り | 画像を渡すにはワークフローの変更が必要。軍帽が若干浮き気味 |
差分画像
まずは基準にする画像を選ばないといけません。参考画像の特徴を引き継ぎつつ可愛さもあるのは、ComfyUI のノイズ除去 0.5 と ChatGPT です。ComfyUI は若干顔が傾いているのが気になり、ChatGPT は背景が透過されているのが問題になりそうです。各 AI で透過画像を渡しても問題ないかどうかの実験も兼ねて ChatGPT の画像を基準にします。
差分画像は Peraravatar+ で元の画像と差し替えて表示するので、ずれがあると表情を切り替えた瞬間に体全体が動いたように見えます。同じサイズで同じ位置を保ったまま差分画像が出力されるのが理想です。
通常の PNGTuber で必要なのは、目を開けて口を閉じた画像・目を開けて口を開けた画像・目を閉じて口を閉じた画像・目を閉じて口を開けた画像の4パターンです。今回は同じ画像のまま部分修正ができるかを見たいので、元の画像の目だけを閉じた画像が出力できるか試します。
ChatGPT
この画像の目を閉じてください 目以外の部分は一切修正しないでください
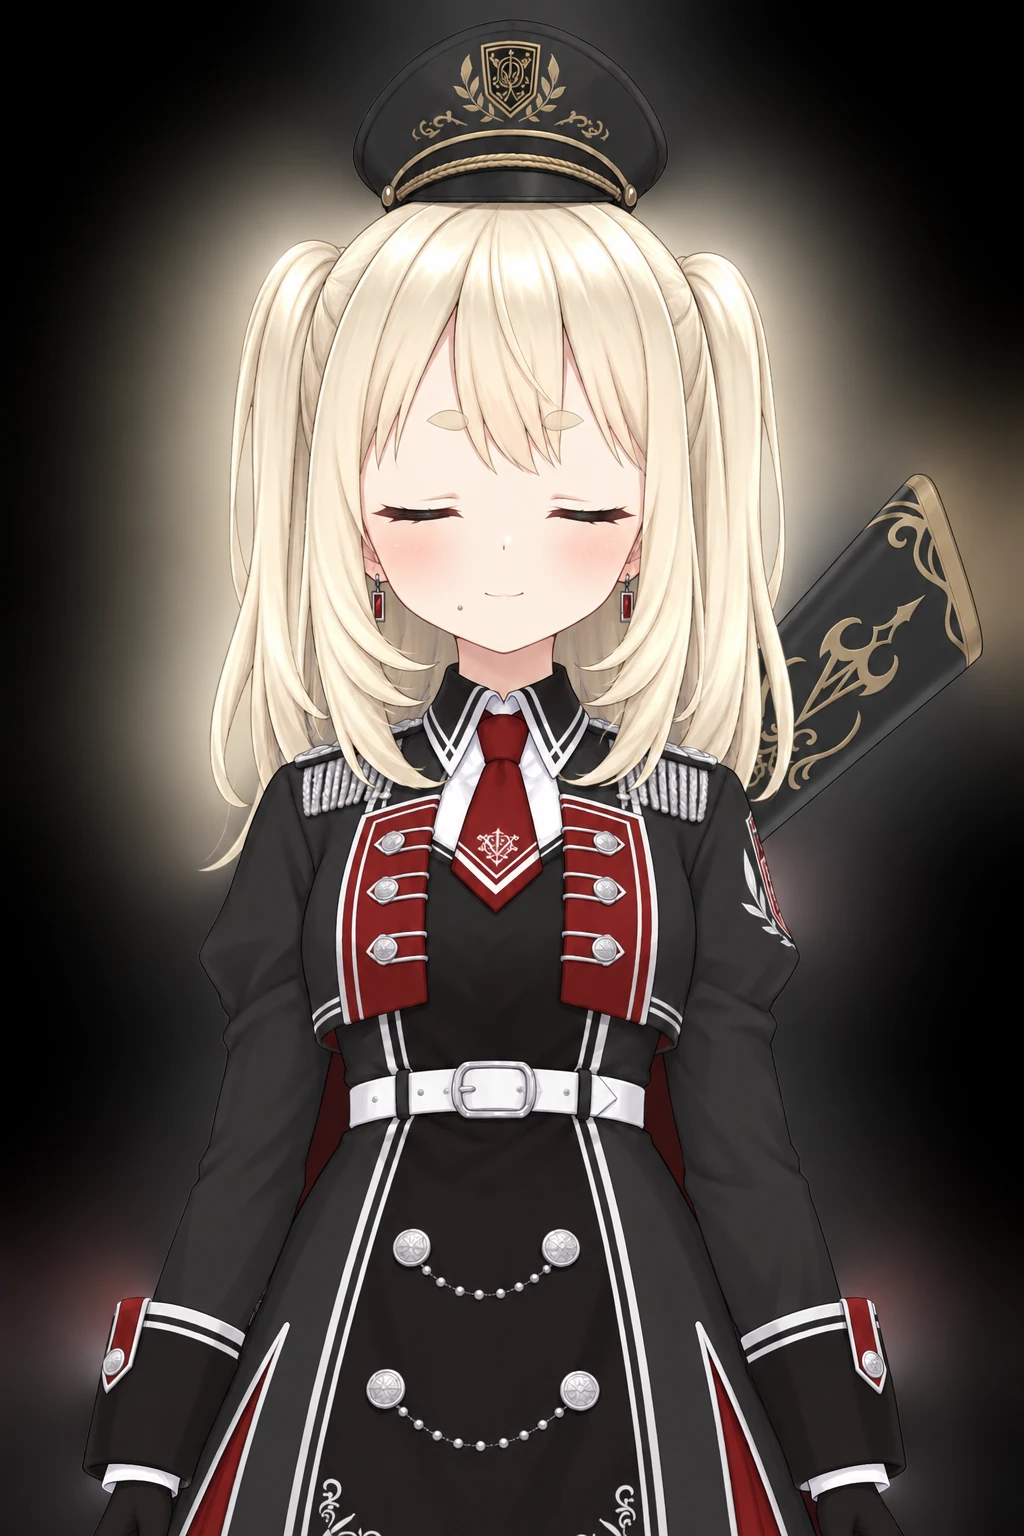
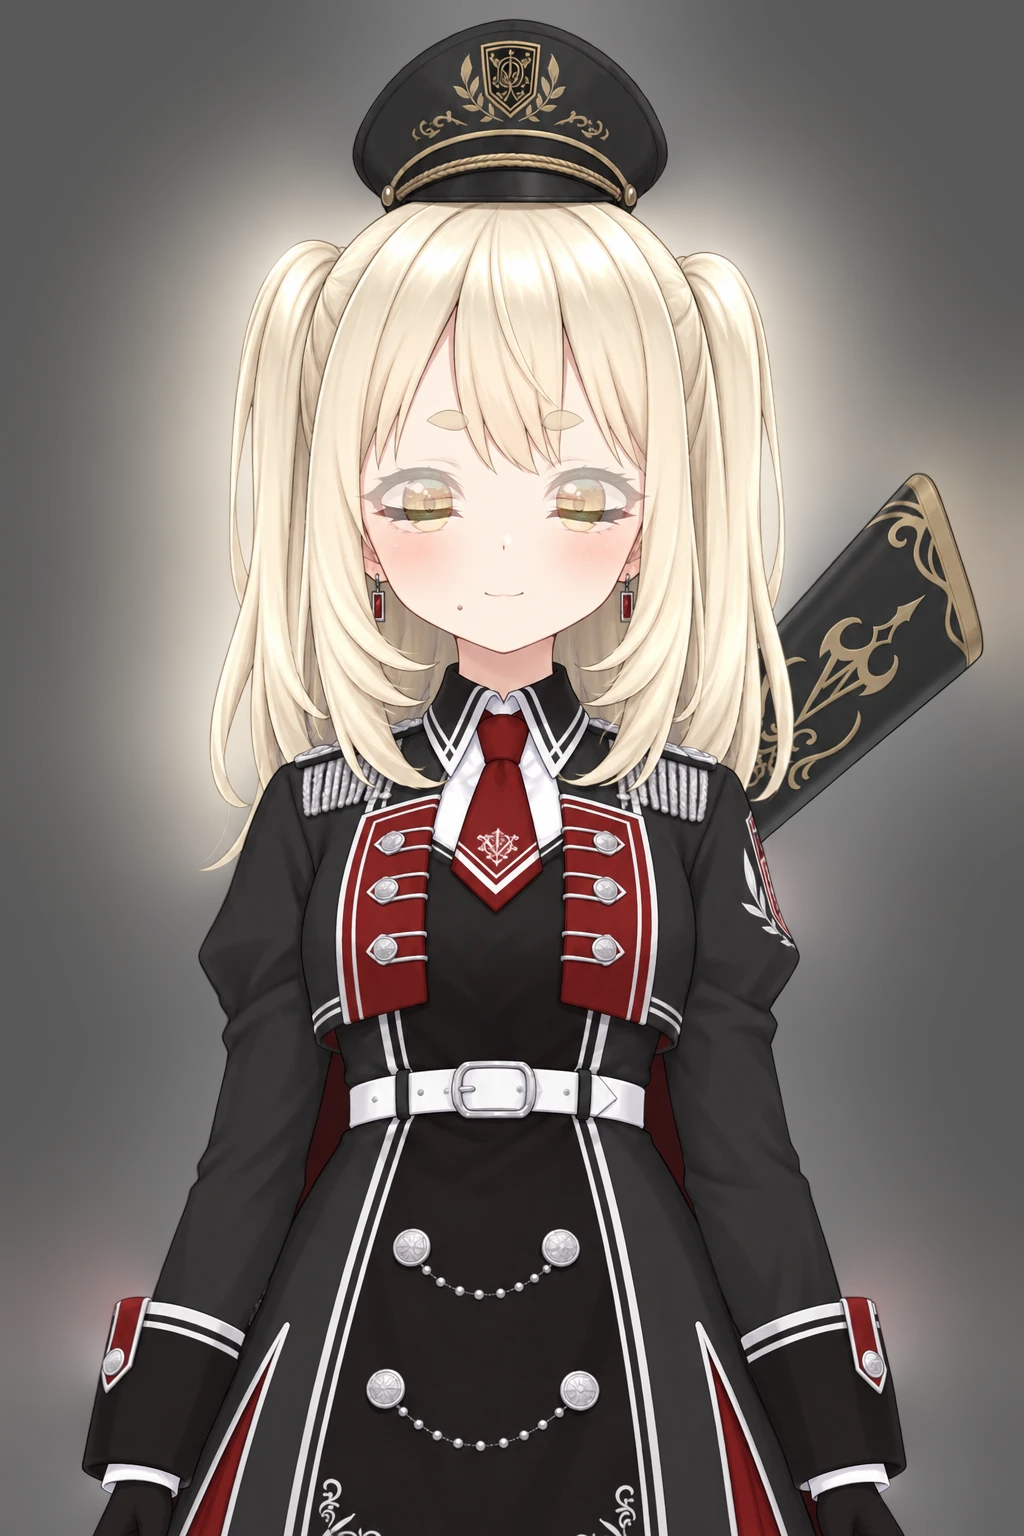
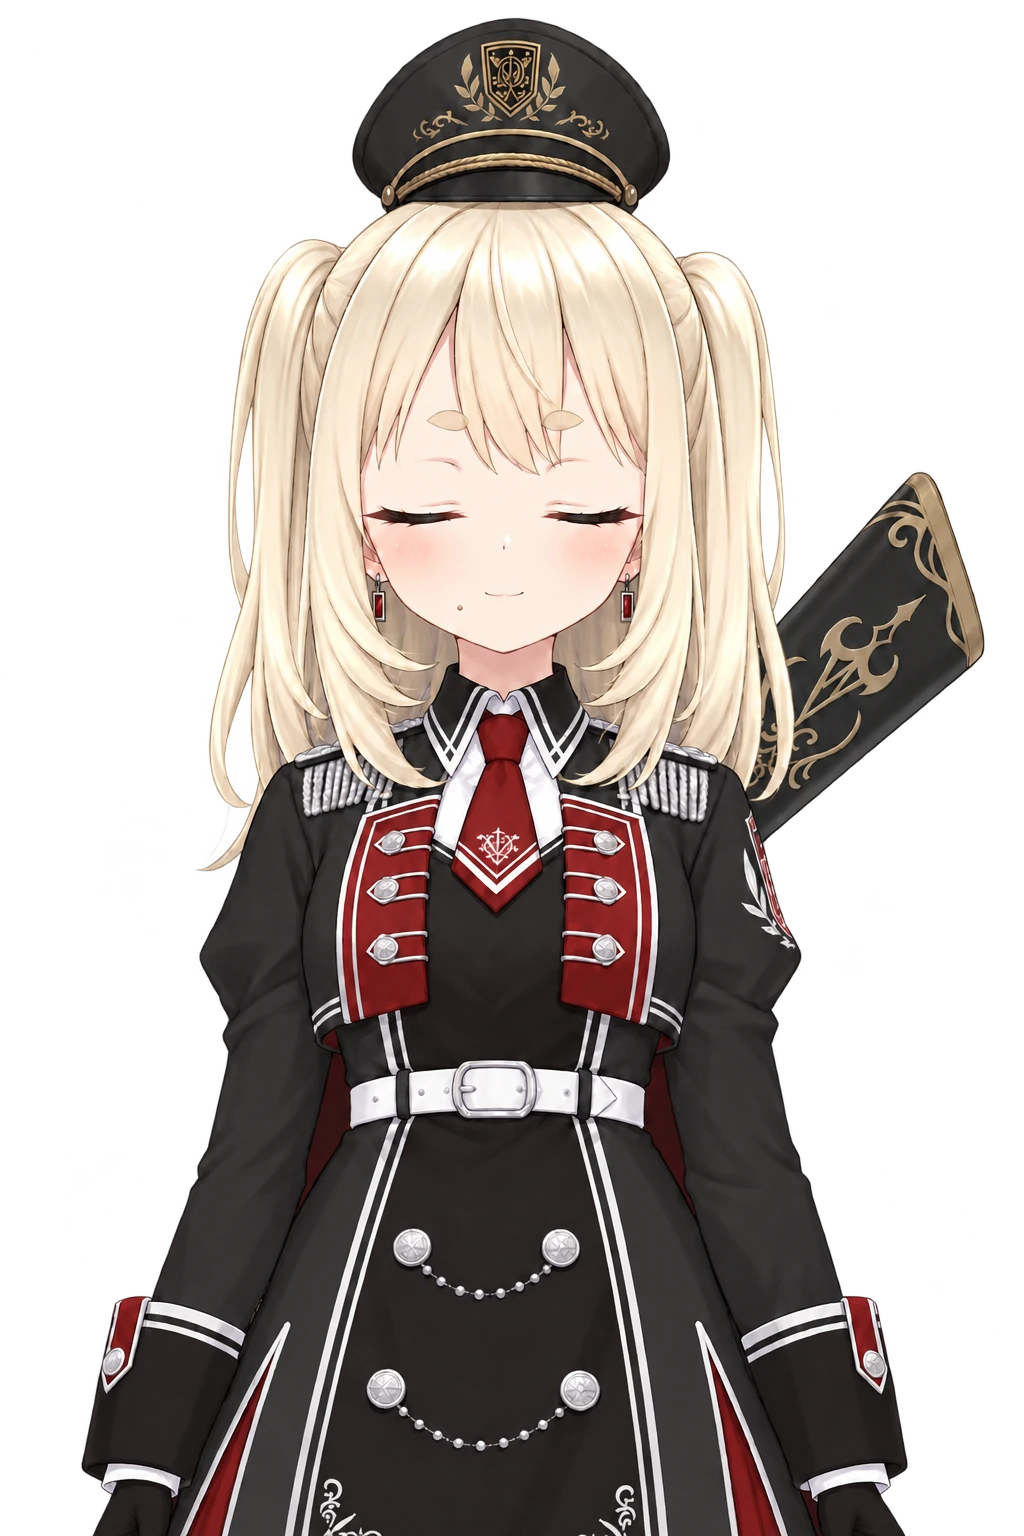
早速背景透過の弊害が出ましたね。透明だった背景が黒で解釈されて、塗りに使った色が周りにぼやっと乗せられています。目だけ閉じられたように見えますが、細部を確認するとネクタイの柄やボタンの描き込みなどは変わっています。
念のため背景を白にしてもう一度やってみます。
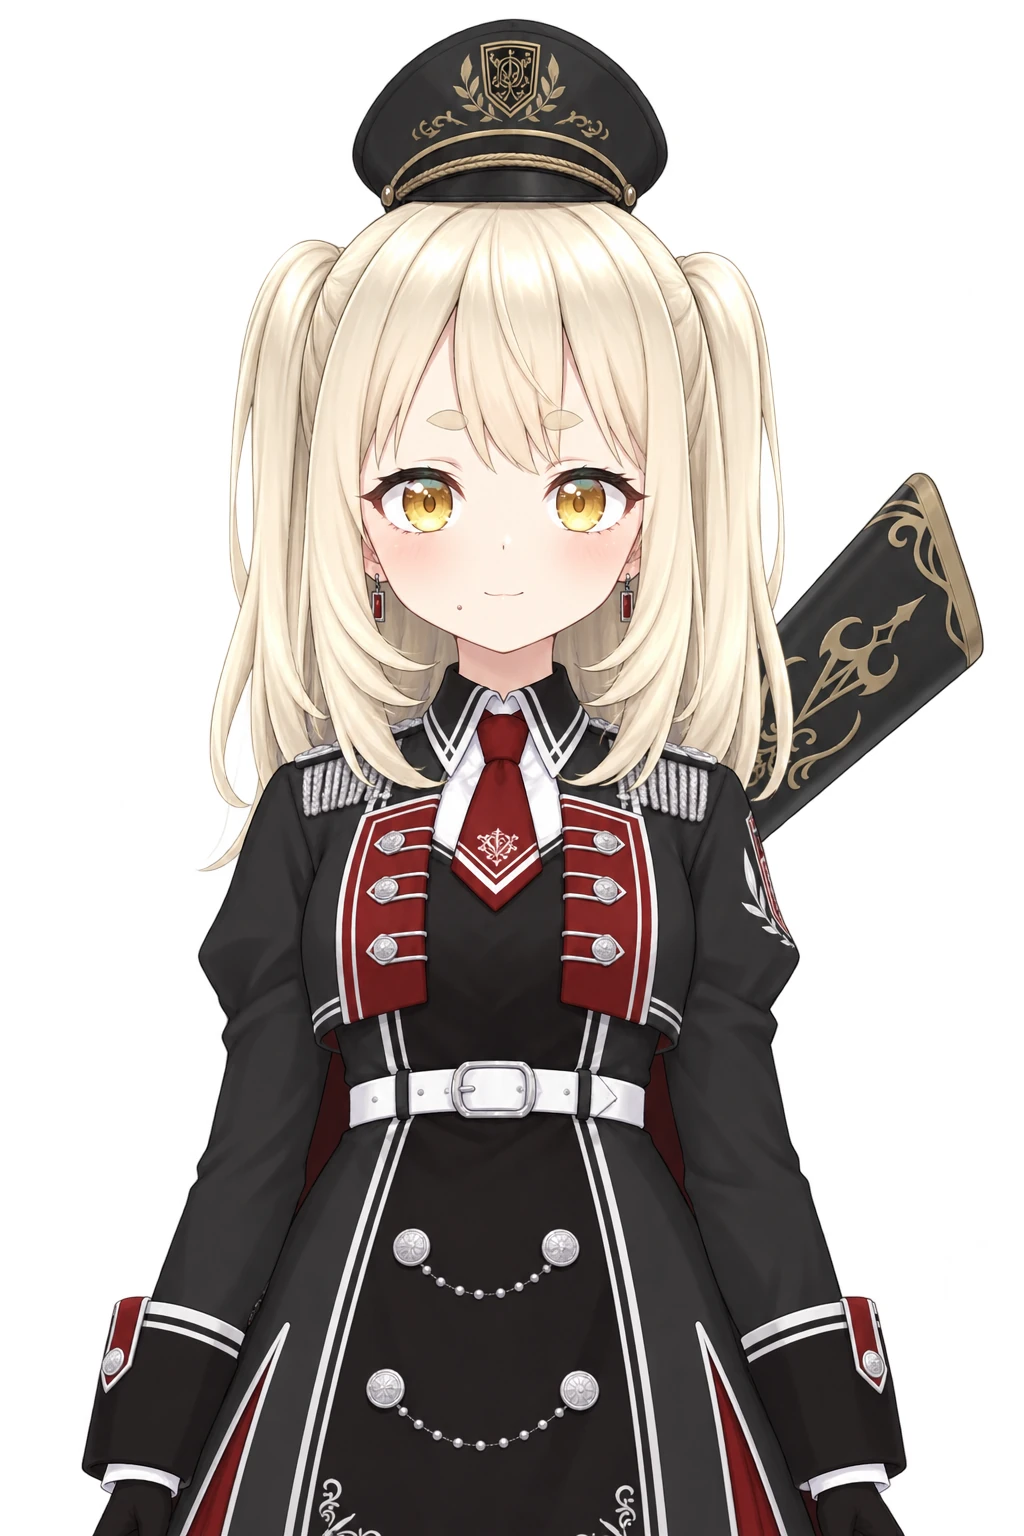
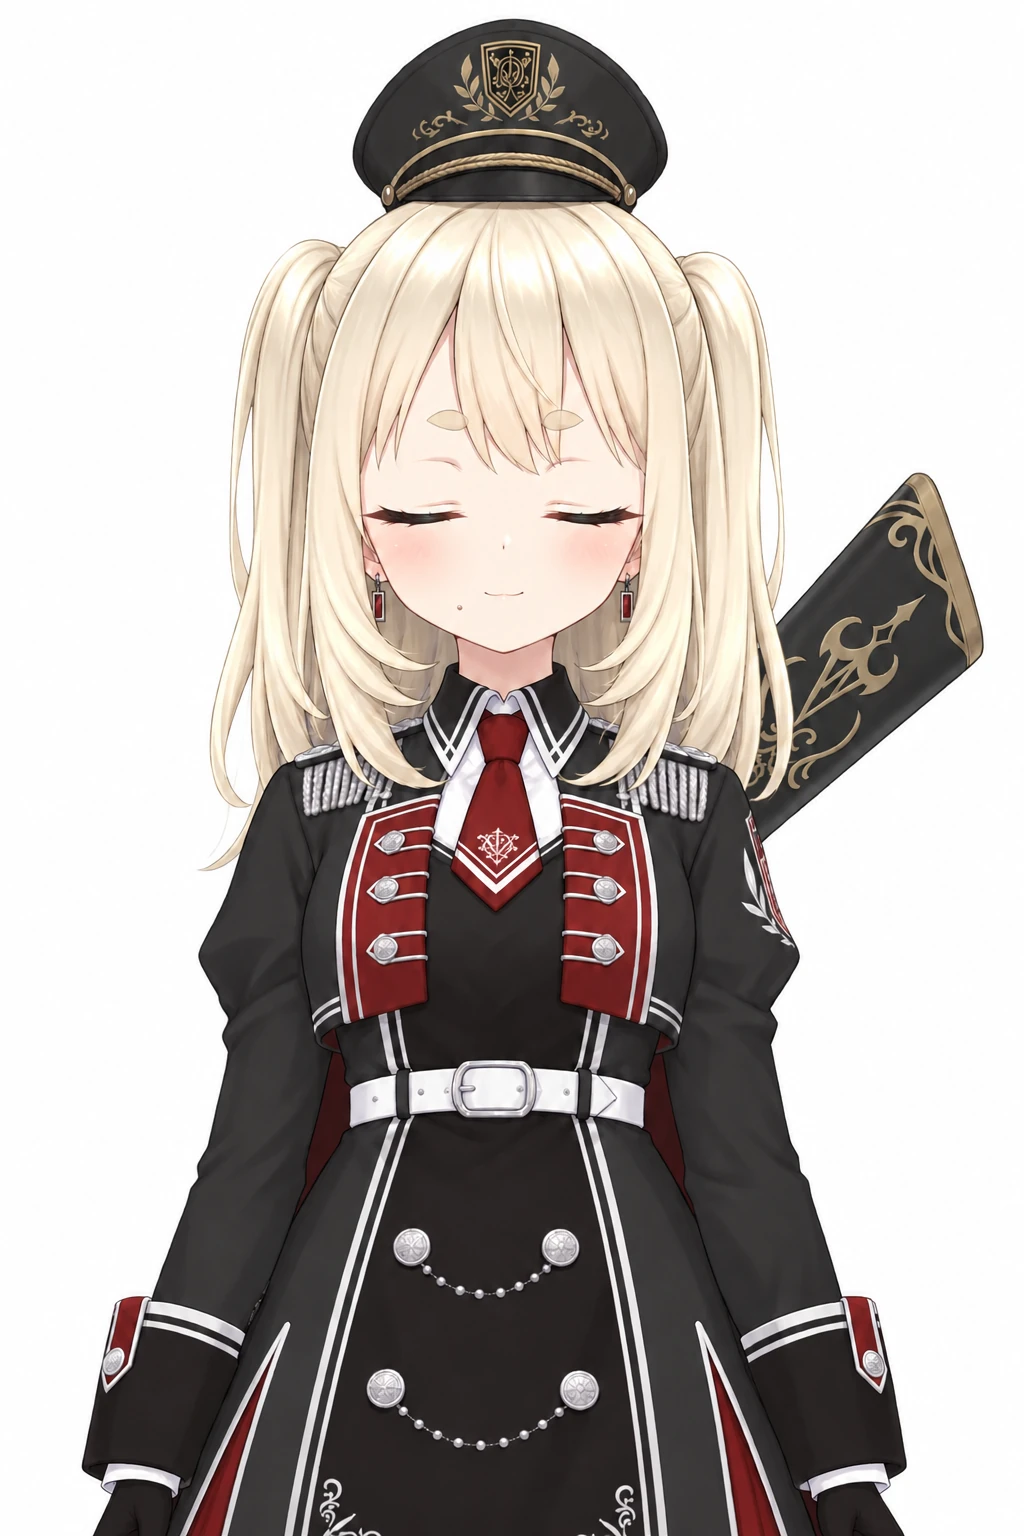
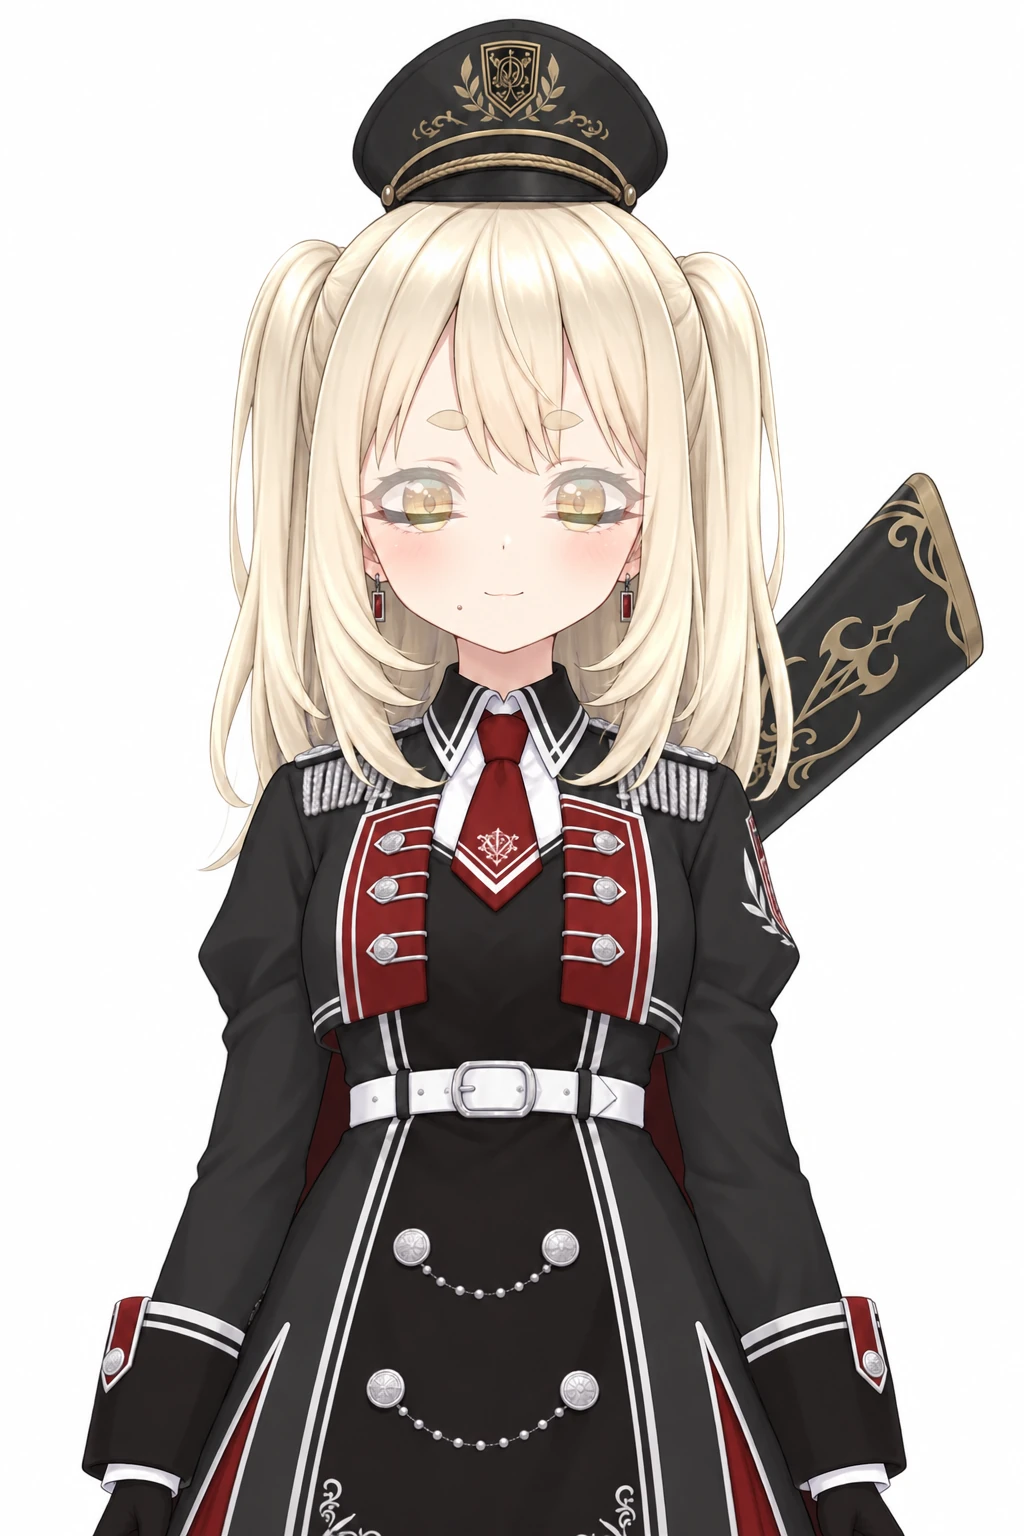
画像生成の仕組み上、毎度全体を再描画しているので全く同じというのは難しいとは思います。でもよく見ないと分からない程度の差なので細かいことが気にならない人はこれでも十分じゃないでしょうか。私は気になるので、この場合はお絵描きソフトで目だけくり抜いて元の画像に重ねて別画像を作ります。
Gemini
ChatGPT と同じ指示をして画像を渡します。
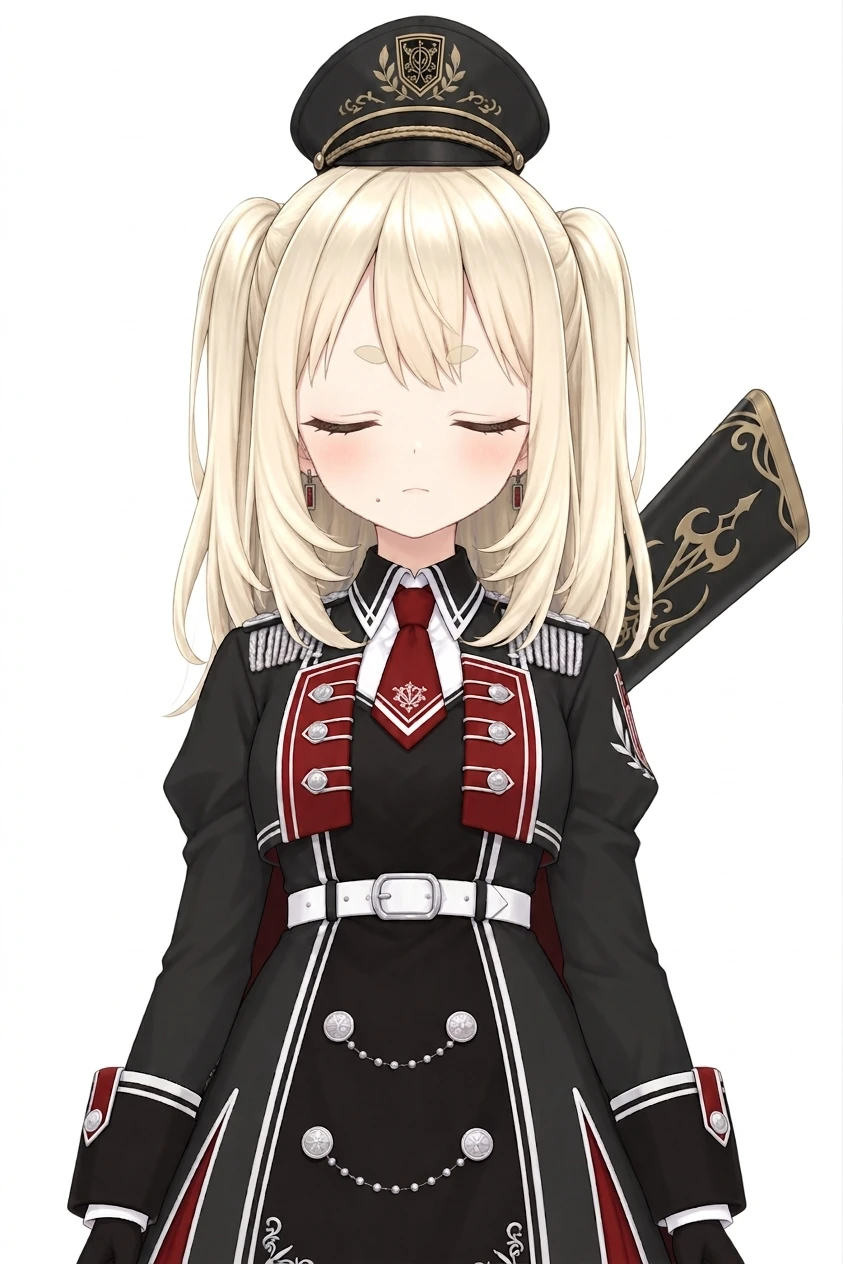
背景透過も白塗りも同じ結果でした。この点だけ見ると Gemini が優秀なのかと錯覚しますが、Gemini はそもそも JPG しか扱えないので透過が認識されず「自動的に透明部分は白か黒で塗りつぶされる」というのが真相じゃないでしょうか。
画像サイズは元の画像の 1024 × 1536 より一回り小さい 843 × 1264 で、形式は JPG です。比率は変わっていないので拡大して重ねてチェックします。目以外を一切変えるなと指示しましたが顔全体が変わっています。眉が下がり、目を閉じ、口も一文字に結び、耳の位置も上がっています。表情の変化としては正しいかもしれませんが、指示内容は守られていないですね。目を閉じたのに合わせて眉が下がるのは許せますが、口が変わったのはちょっと許容できません。瞬きの度に口を閉じる特殊体質の人はこれでも満足できると思います。
こちらも ChatGPT と同じく、重ねて比較すると服の細部は変わっています。
Grok
ChatGPT と同じ指示をして画像を渡します。
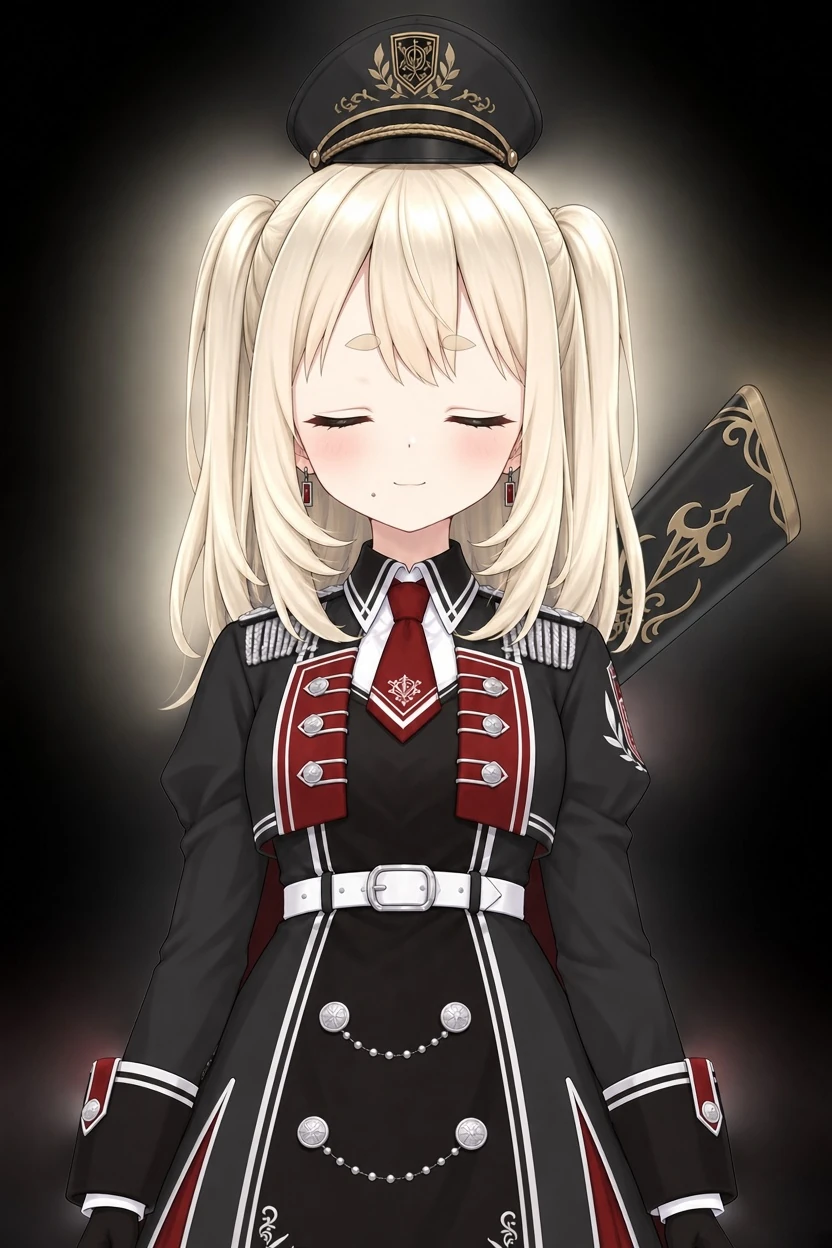
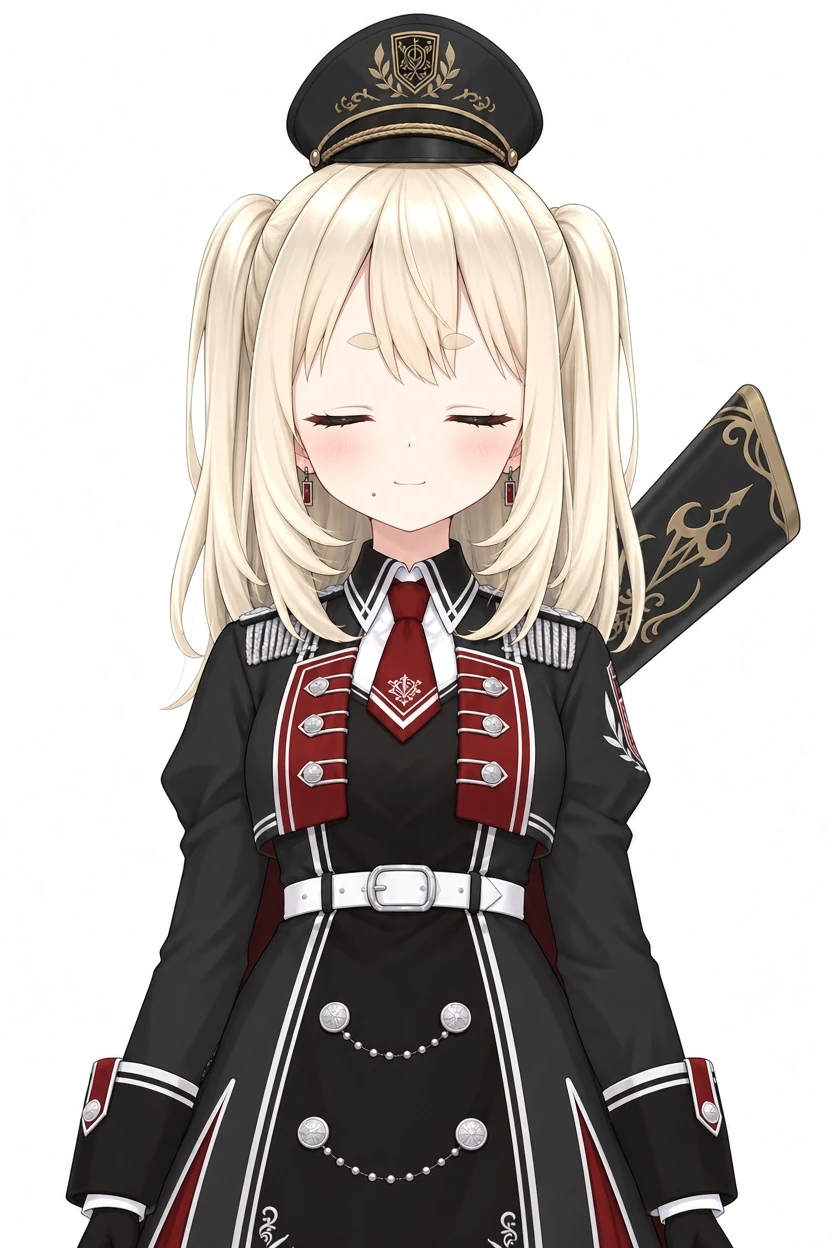
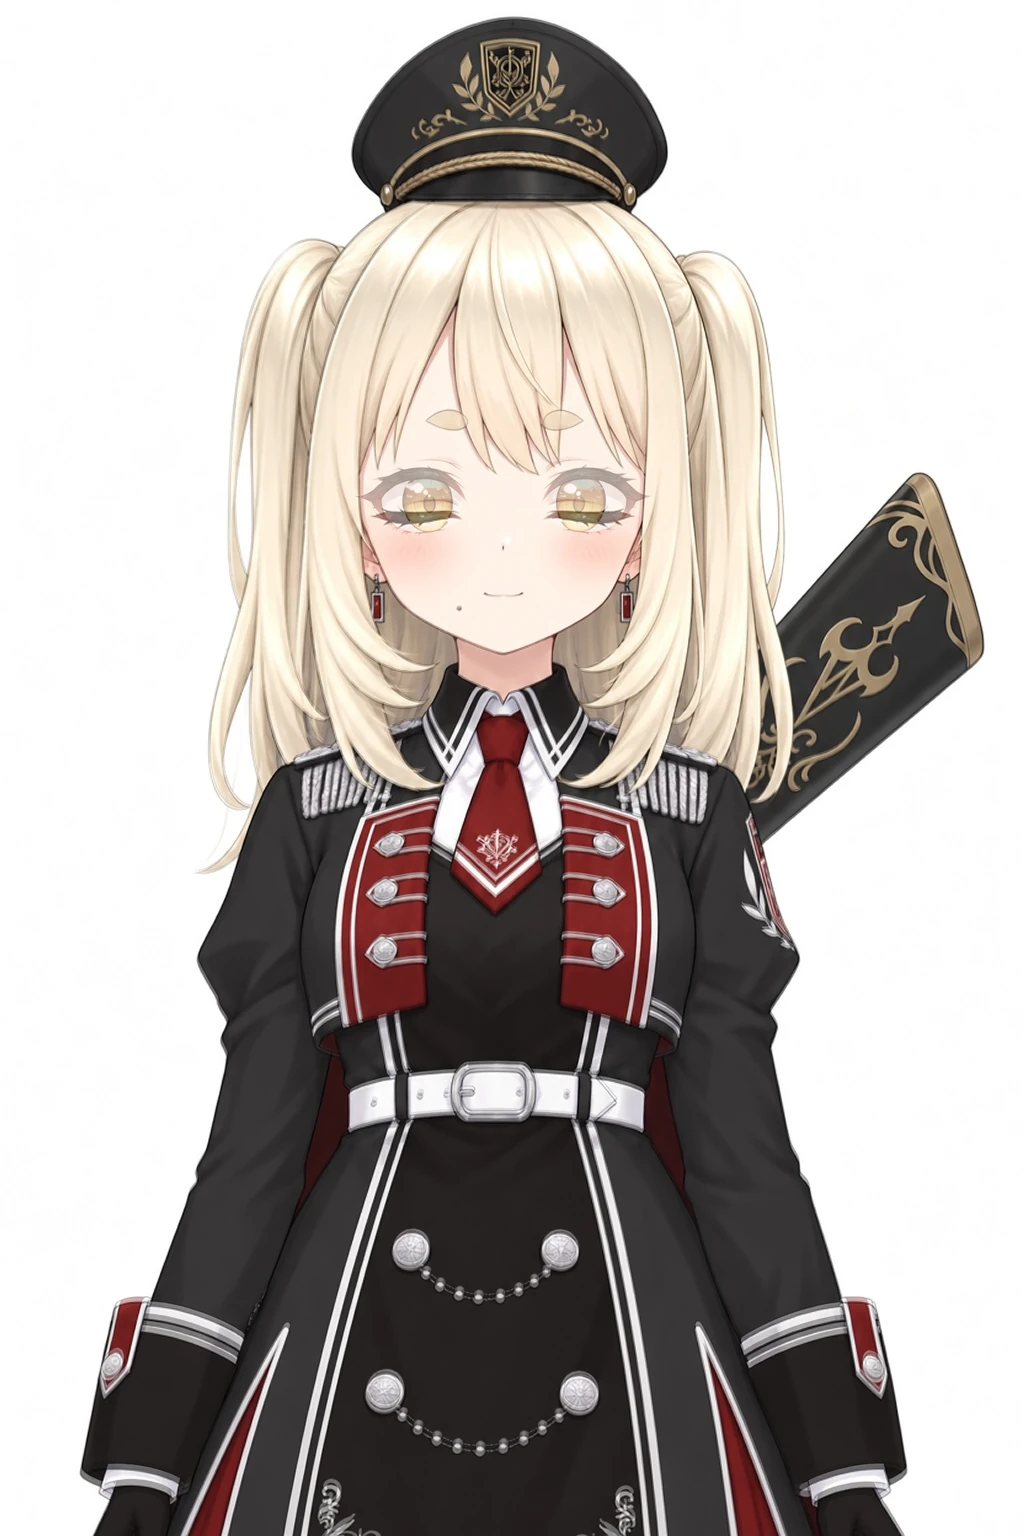
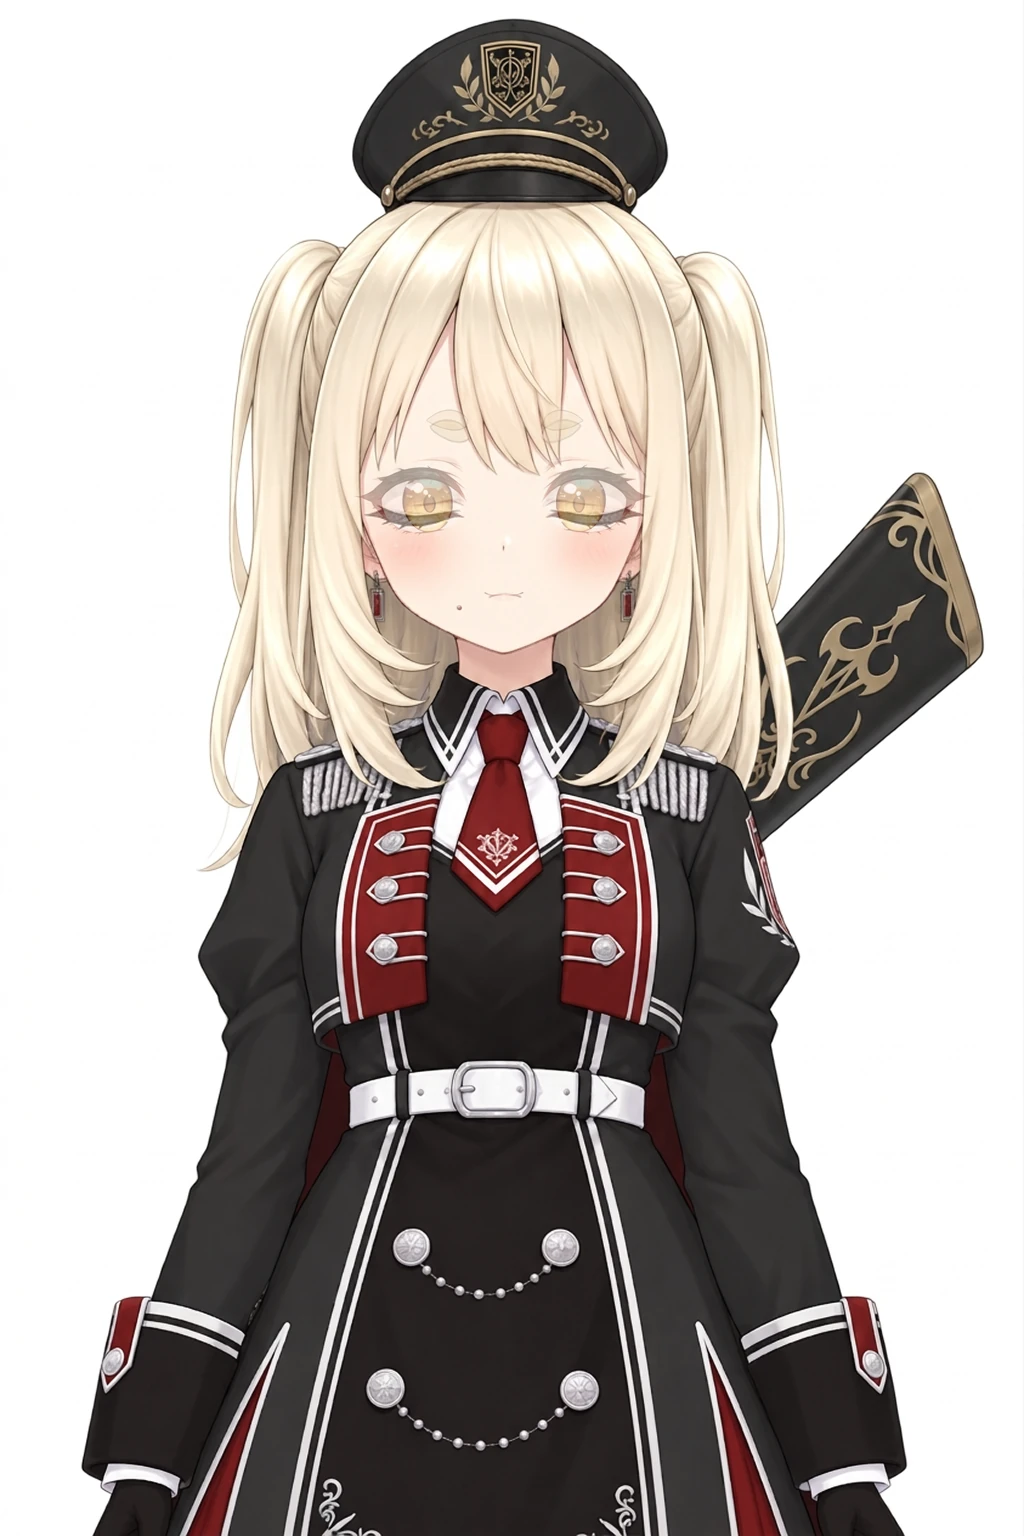
透過画像を渡したら ChatGPT と同じように黒背景にぼやっと色が乗りました。透過は扱えないようですね。Gemini と同じく画像サイズも元の画像の 1024 × 1536 より一回り小さい 832 × 1248 になりました。描画位置も元の画像からズレていて切り替わりの度に 2px 程度位置が動きます。
さすがに瞬きの度に位置ズレするのは許容できないですね…。
PixAI
PixAI には「リペイント」という機能が用意されているので、この機能で部分的に再描画できます。ChatGPT・Gemini・Grok は指示される度に全体を再描画するので、これを比較に出すのは微妙ではあるんですが、今回大事なのは「PNGTuber に使う画像を用意するために、最適な表情差分の作り方」を模索することなので一旦細かいことは置いておきます。
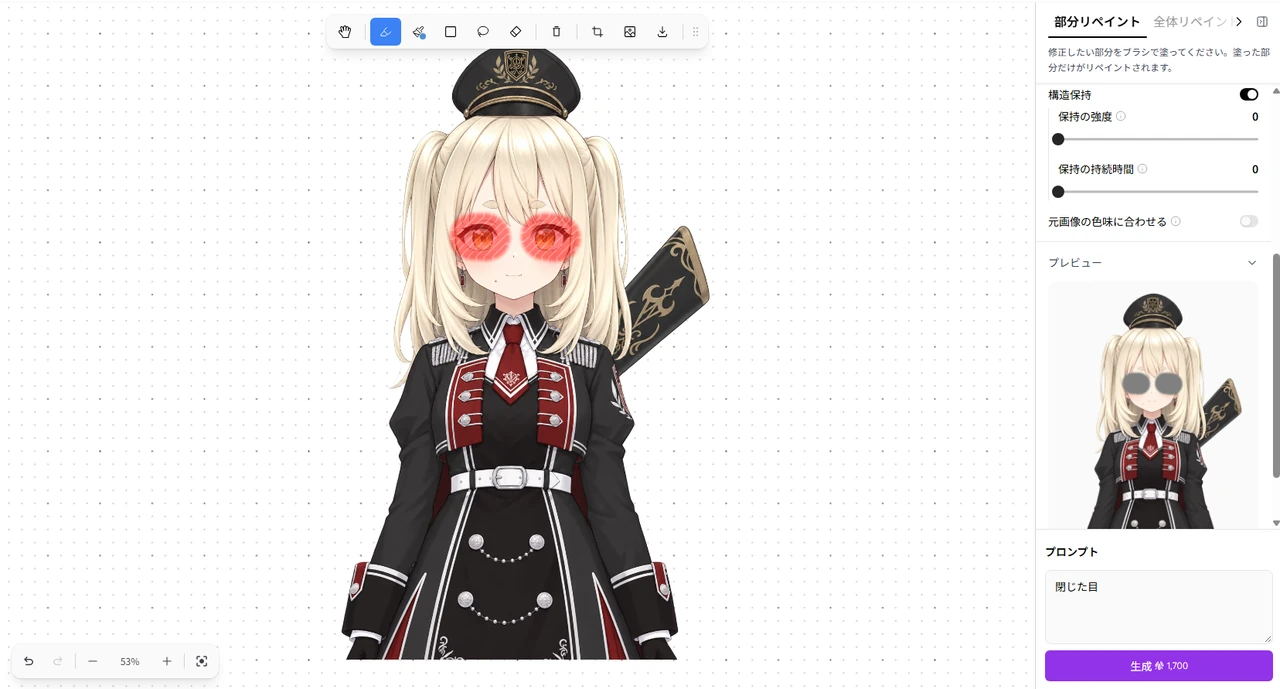
今回は目だけにマスクをして眉毛は含まないようにしました。眉毛も含めると目といっしょに少し位置を下げてくれると思います。その他のパラメーターは初期値のままです。
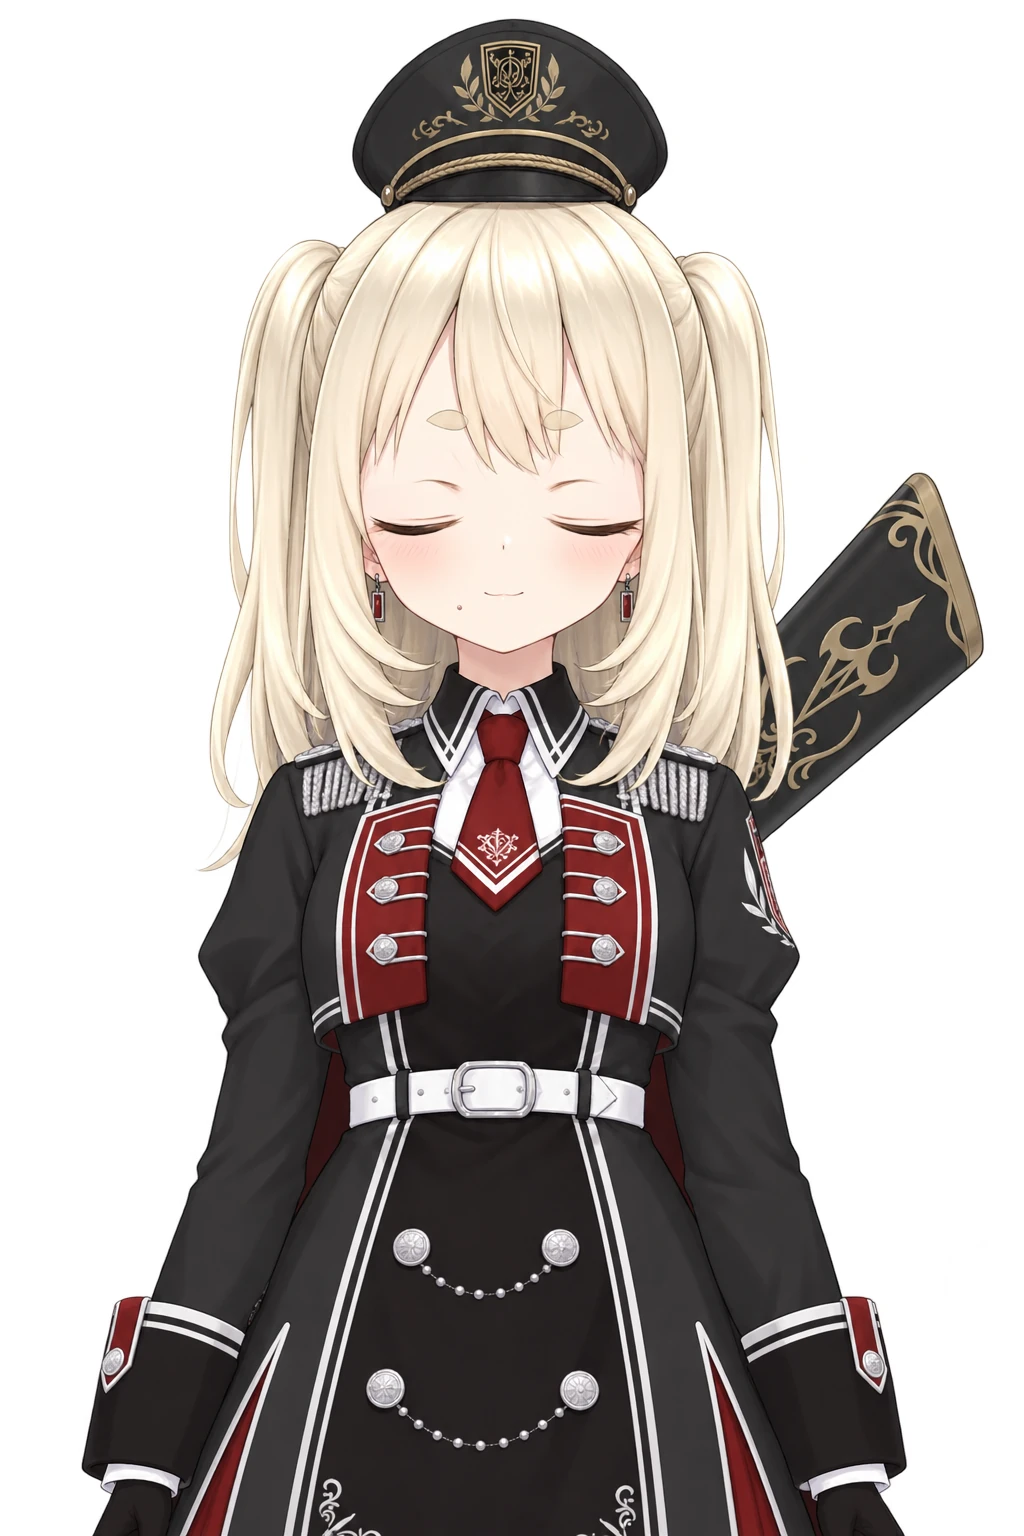
これもう正解だろ。まあ、これはそのための機能ですから当然の結果ではあるんですけどね…。背景は自動的に白になりました。画像生成特化の AI にはこの機能があるので、これを使いこなせる人は全部の表情差分これでいいと思います。別に PixAI の中で生成した画像じゃなくてもアップロードしてリペイントできるので、とにかく1枚「これ!」と思える立ち絵さえ用意すれば、泣いたり笑ったりもさせられます。一応元のプロンプトを渡さないとリペイント時の絵のスタイルが変わっちゃったりもあるので、広範囲にマスクしてリペイントとなるとコツは必要です。私はまだ使いこなせていないので、調子に乗ってポーズ変えようとしたら化物が生まれました。難しい…。こいつを使いこなすには少しお勉強が必要です。
ComfyUI
ComfyUI はインペイントで、目だけをマスクして再描画します。モデルは先程と同じ WAI-illustrious-SDXL v16 です。やることは PixAI のリペイントと同じです。ワークフローの話は割愛します。
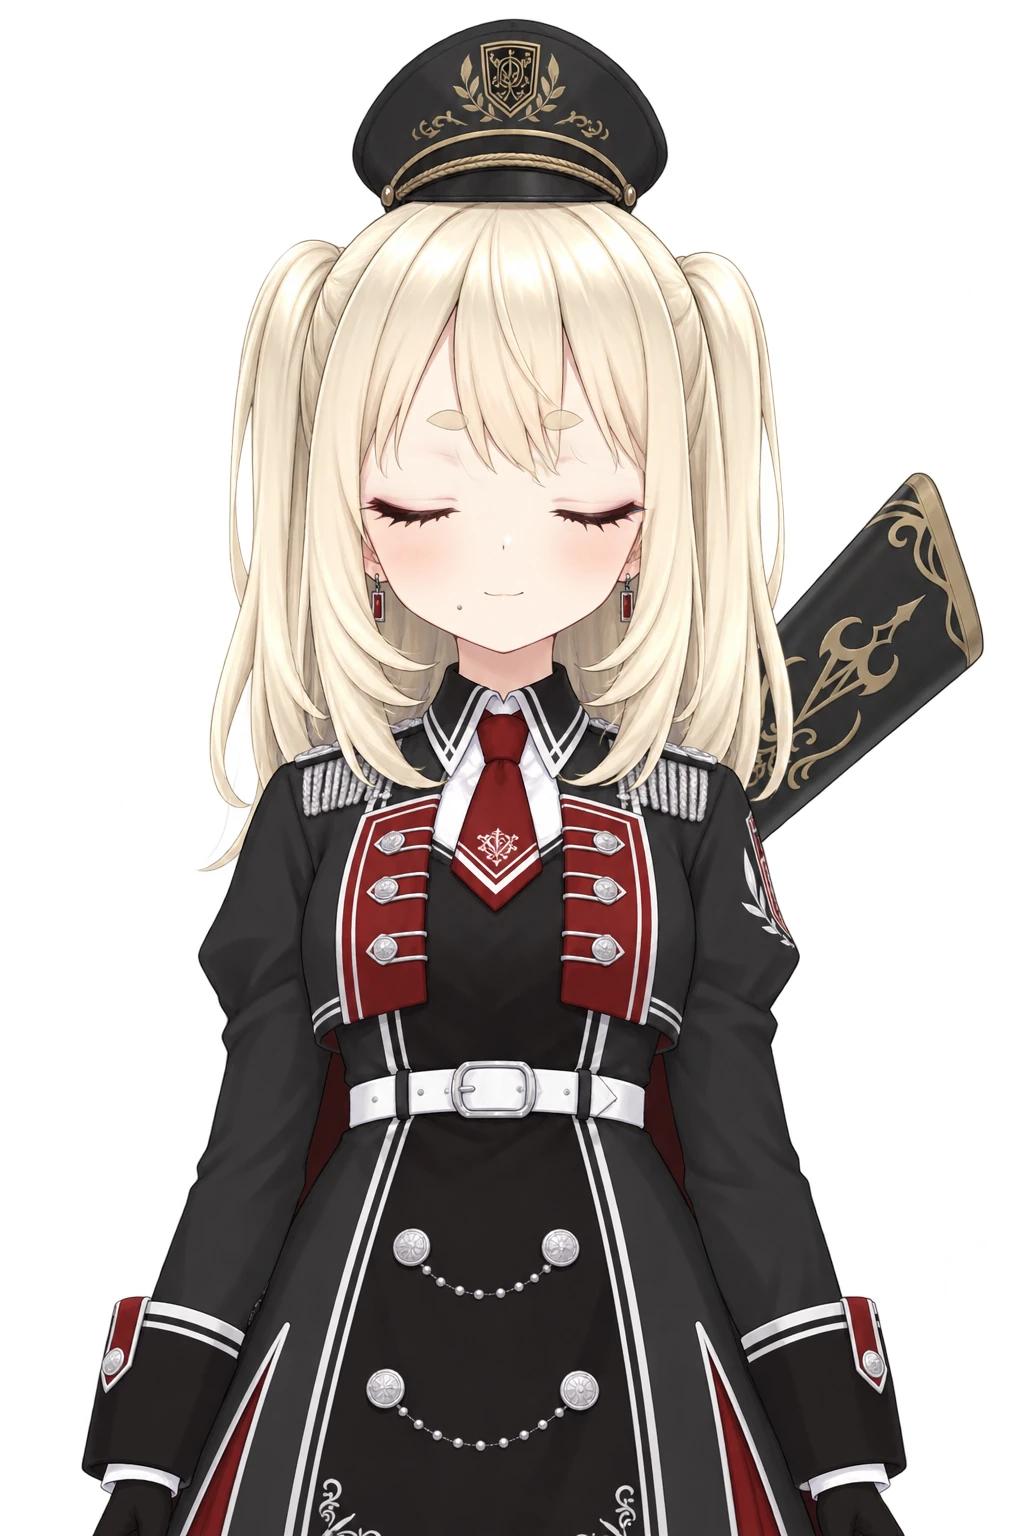
パッと見よさそうに見えますが、前髪などの目と被る部分は崩れています。この前髪が微妙な状態の画像を出力するだけでもかなり時間がかかってます。ComfyUI は自由にいろんな出力ができる反面、理想の出力をするまでのパラメーターやプロンプトの微調整が大変です。ここに労力使うなら自分でお絵描きソフトで描き加えたほうが絶対早いです。
差分画像のまとめ
| AI | よかったところ | 気になったところ |
|---|---|---|
| ChatGPT | 目以外はほぼ保持された | 透過画像を渡すと、背景が黒で解釈されて色がぼやっと乗る。毎回全体を再描画するので、ネクタイの柄やボタンの描き込みなど細部が変わる |
| Gemini | 表情の変化としては正しいかもしれない | JPG しか扱えないので透過が認識されない。画像サイズが 843 × 1264 に小さくなる。眉が下がり、口が一文字になり、耳の位置も上がるなど顔全体が変わる。服の細部も変わる |
| Grok | — | 透過画像を渡すと、黒背景に色がぼやっと乗る。画像サイズが 832 × 1248 に小さくなる。描画位置が 2px 程度ずれる |
| PixAI | リペイントで目だけを再描画できる。PixAI 以外で作った画像もアップロードしてリペイントできる | 元のプロンプトを渡さないと絵のスタイルが変わることがあり、広範囲にマスクしてリペイントするにはコツが必要 |
| ComfyUI | インペイントで目だけを再描画できる | 前髪など目と被る部分が崩れる。理想の出力をするまでのパラメーターやプロンプトの微調整が大変 |
背景除去
背景が白で出力された画像は、PNGTuber で使う前に背景を透過します。ChatGPT と Grok には、出力した画像の背景を消す機能があります。
ChatGPT
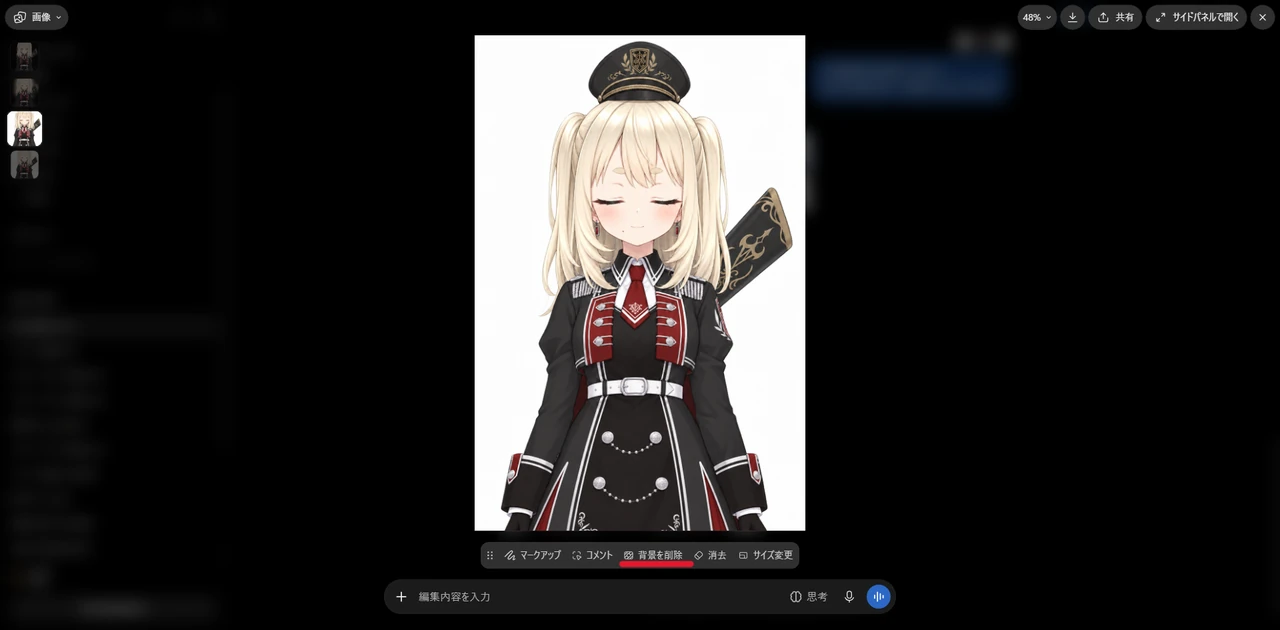
ChatGPT は、画像をクリックすると画像の編集メニューが下部に表示されます。その中に「背景を削除」があります。「じゃあ自分でお絵描きソフトで透過する必要ないじゃん!」と思いますよね?この処理で画像1枚生成したことになるので、無課金ユーザーは貴重な画像生成の回数をこれで消費することになるんです。課金していて画像生成の回数に余裕があり、手っ取り早く透過したい人はこれでいいと思います。私のように「ChatGPT はすぐにリセットされるから待てるもん」と言いながら、画像生成の回数を限界まで節約して別の画像生成に使おうとする貧乏性且つお絵描きソフトに慣れている人間は自分で透過した方がお得なんです。
Grok
こちらも ChatGPT と同様、画像をクリックすると編集の画面が開きます。
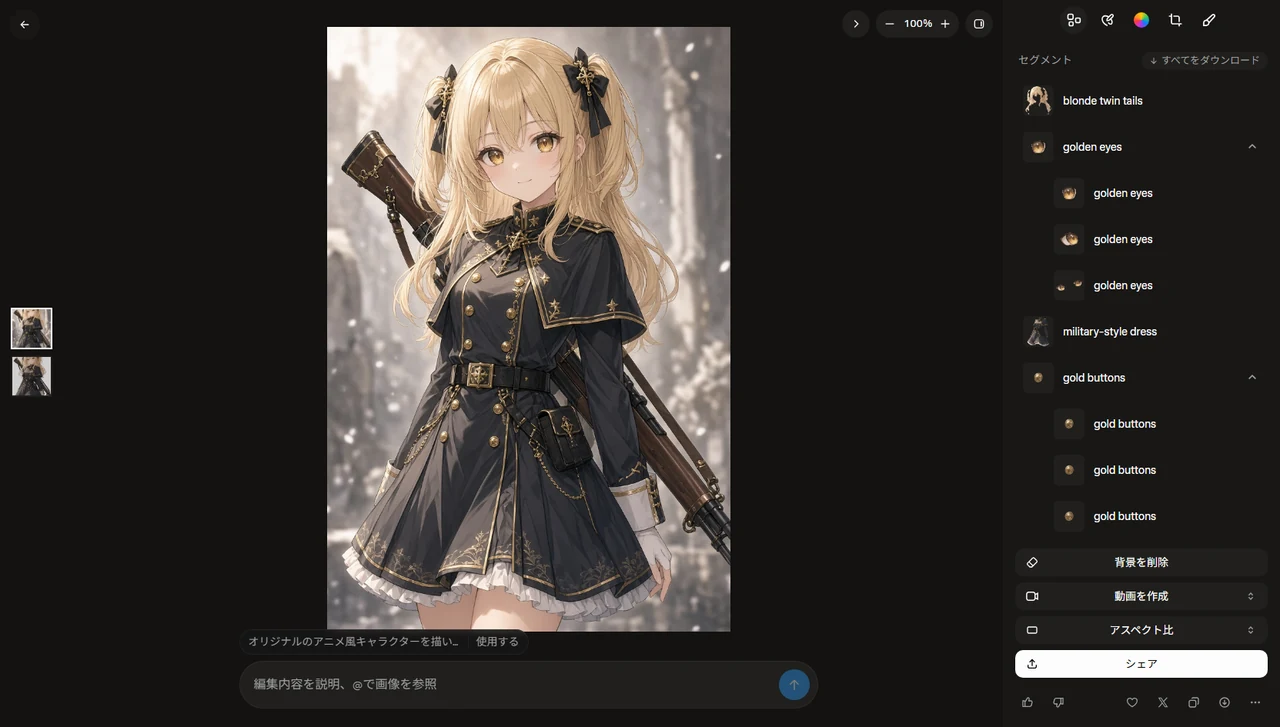
右のメニューの下の方に「背景を削除」があります。それをクリックすれば背景を除去してくれます。おそらくこちらも画像生成の回数を消費してると思います。
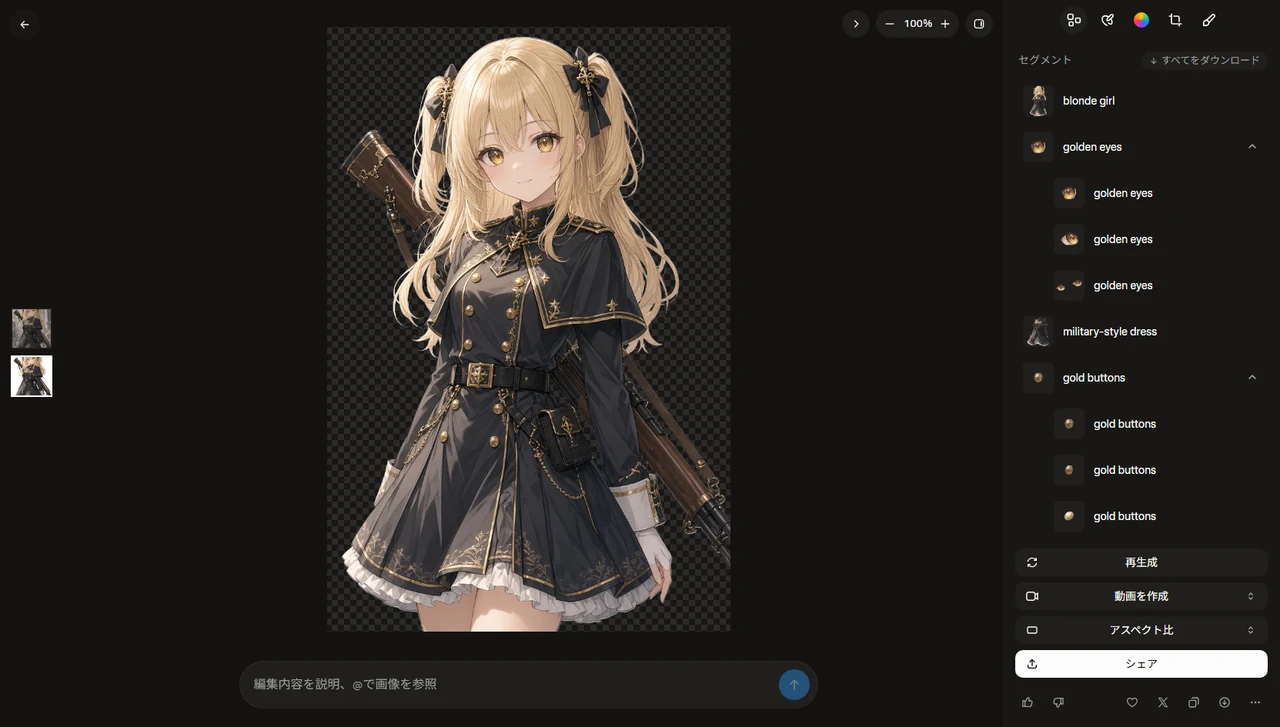
あれ?もしかして Grok って実はかなり優秀なのでは?セグメントから画像の各パーツの再生成やダウンロードもできるので、まさに PNGTuber で求められている機能が揃っていると言えそうです。
でも無料でできるのはここまでです。パーツの部分再生成や動画変換などは有料プランへの登録画面が表示されました。無料の範囲で PNGTuber を作ろうと思うと結局最初のパーツ以外は別で用意することになるので、他の AI 使うのと大差ないですね。差分画像生成の比較では褒めるところがなかった Grok くんですが、この課金プランにあるパーツの部分生成は実質 PixAI のリペイントと同じ機能だと思うので、かなり楽に PNGTuber の素材が用意できるんじゃないでしょうか。今回は無料の範囲でという縛りでやっているのであまり褒めるところがありませんでしたが、課金さえすれば最強になれる可能性を感じました。
お絵描きソフトで透過する
AI で透過しても綺麗にならないとき、画像生成の回数を消費したくないときは自分で背景を消します。手順は前の記事で紹介しています。
 FireAlpacaとマウスだけで絵を加筆修正する手順 マウスだけで絵の加筆修正は可能。FireAlpaca で、背景の透過、線のガタつきの修正、目と口の消し方まで。
まとめ
好みの問題もありますが、私の評価はこうです。
| AI | キャラデザ | 画像から再生成 | 差分画像 |
|---|---|---|---|
| ChatGPT | ○ | ○ | △ |
| Gemini | × | × | △ |
| Grok | △ | △ | × |
| PixAI | ○ | △ | ○ |
| ComfyUI | ○ | ○ | △ |
やっぱり使い慣れている ChatGPT を贔屓目で見てしまっているとは思います。楽なんですよね。あんまり長々と指示しなくてもいい感じの画像を出力してくれる事が多いので…。「こんな感じの絵柄にしてください」と画像を渡せばそれっぽい仕上がりのものが返ってくるので、一番人間に近い感覚でやり取りが成り立っていると思います。
Gemini は使い慣れていないこともあり、もっと適切な指示ができればより良い画像が生成できるとは思います。ですが、そこに労力を割くのであれば PixAI や ComfyUI の使い方を覚えるのにその労力を注いだほうがいい画像が出力できるのでは?という気持ちもありイマイチ評価しづらいです。改めて検証するとちょっと微妙だと感じましたが、Peraravatar+ のドキュメントの左下でぴょんこぴょんこしているアバターの「びっくり」「笑い」「泣き」の表情は Gemini で出力したものです。元の画像比率(キャラクターの身長や顔のサイズ)を維持したまま別のポーズや表情で画像を生成してくれるという点においては優秀だと思います。これで出力が PNG だったら最高なんですが。
Grok は使ったことがほとんどなかったので今回どんな機能があるかも初めて知りました。課金して使いこなしてたら Grok を満点だと言っていたかもしれません。周りでも ChatGPT と Gemini は話題にする人がいても Grok が話題になることはないので、もったいないなと思います。
今のところ、私がたどり着いた Peraravatar+ の素材作成手順は、
- ChatGPT か PixAI にふわっとした指示でいい感じのアバターを出力してもらう
- お絵描きソフトで破綻箇所や線のガタつきを加筆修正
- ChatGPT で目を閉じたり口を開いたりのパターンで出力させて、必要なパーツだけくり抜く(うまくいかないときは自分で描く)
- お絵描きソフトで各パーツを組み合わせて、破綻しないよう調整する
- Gemini で「びっくり」「笑い」「泣き」などの表情だけでなくポーズも変わる画像を生成させる
- Gemini が出力した画像をお絵描きソフトで加筆修正 + 透過して PNG で保存する
です。楽できるところは楽して、細かいところは人間が手を動かす。
素材が揃ったら、Peraravatar+ で PNGTuber として動かせます。差分画像を1枚ずつ差し替えるなら「各画像を用意する」、目と口のパーツを重ねるなら「1枚絵から作る」を選びます。詳しくは Peraravatar+ のドキュメントで確認してください。パーツを重ねて動かす手順は、こちらの記事で紹介しています。
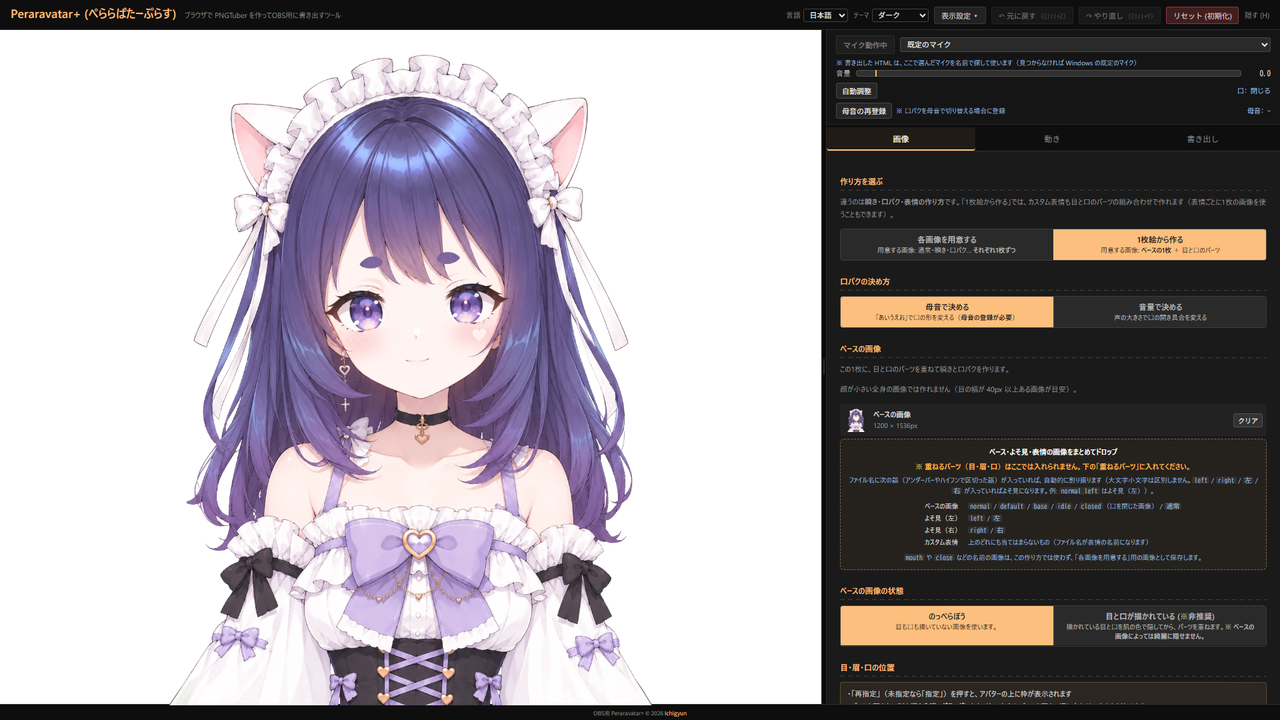 Peraravatar+で配信用アバターを作る手順 PNGTuber の Peraravatar+ で配信用のアバターを作る。AI で生成した1枚絵からのっぺらぼうのベースを作り、プリセットで動かす初級編、目と口のパーツを自分で用意する中級編、胸とアクセサリーを揺らす上級編まで。